Полный перевод статьи из блога Claude на русский. Оригинал — по ссылке.
ПОДКАСТ
ИИ ускоряет непрерывную интеграцию
Инженеры Anthropic в среднем выпускают в 8 раз больше кода за квартал, чем выпускали в 2021–2025 годах. Claude создаёт 80% этого кода и также играет большую роль в проверке и одобрении PR.
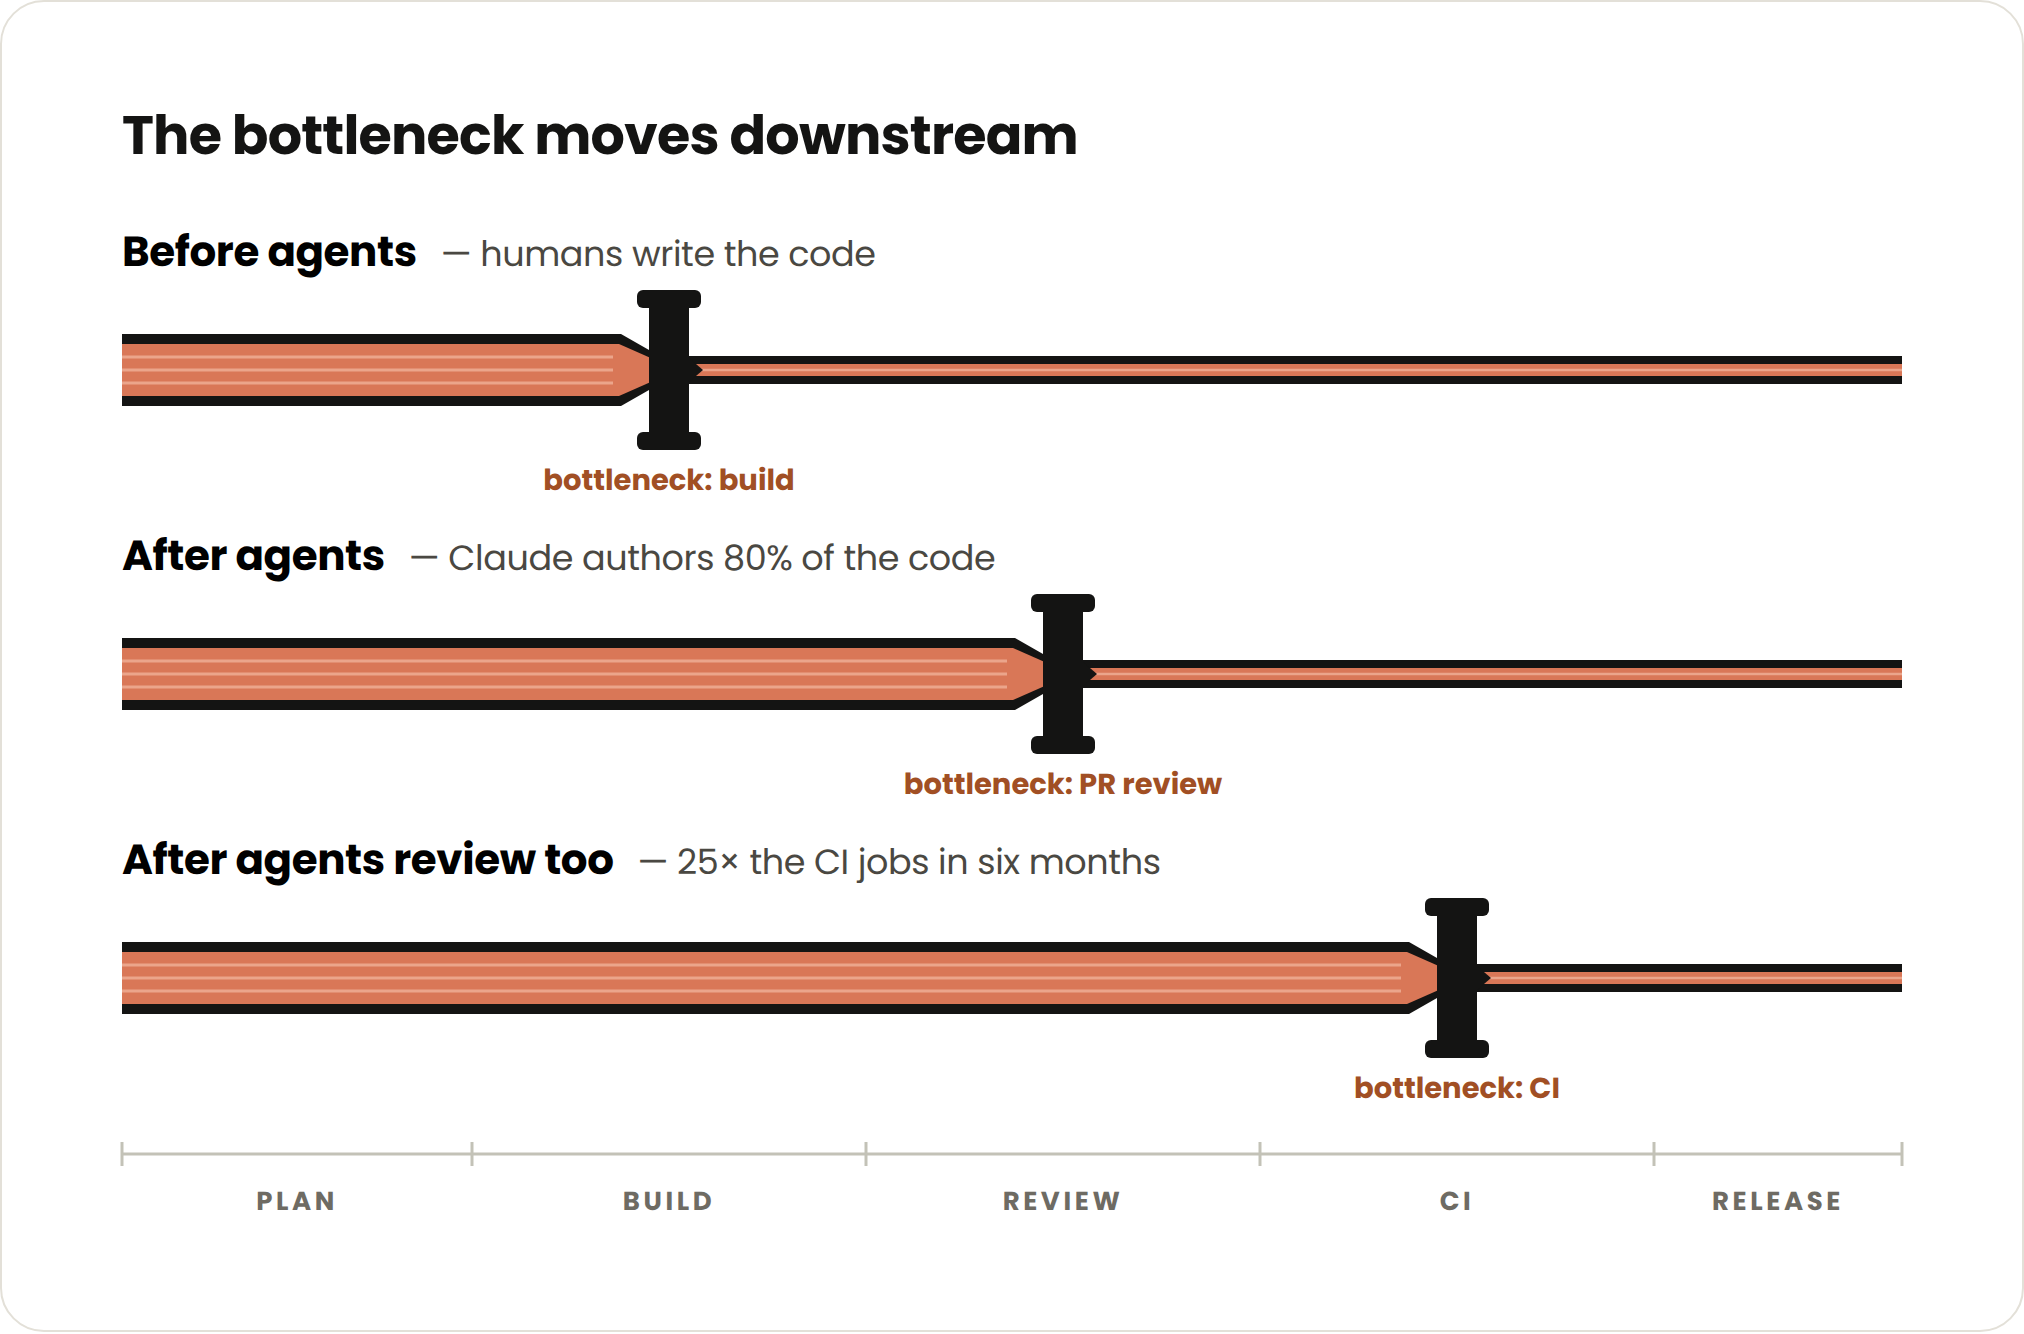
Кроме того, количество тестов в нашей кодовой базе выросло в 10 раз, а число инженеров увеличилось незначительно. Всё это привело к 25-кратному увеличению числа задач непрерывной интеграции за шестимесячный период — если Вы пытаетесь посчитать, не каждый тест запускается для каждого PR, как я объясню.
Это несколько раз угрожало перегрузить нашу службу анализа влияния тестов. Чтобы не стать следующим узким местом, мы полностью перестроили всё и заново представили, как должна выглядеть архитектура службы. Но путь к этому был непростым и начался с трёх быстрых исправлений, которые продержались соответственно 70 дней, затем 29 дней, а затем менее одного дня.
Масштабирование непрерывной интеграции — это задача, с которой, вероятно, вскоре столкнётся всё больше инженерных команд, поскольку агенты продолжают ускорять генерацию и проверку кода. Я предполагаю, что горизонтально масштабируемая архитектура отбора тестов станет отраслевым стандартом, поскольку команды, использующие агентов, создают и больше запросов на включение изменений, и больше тестов.
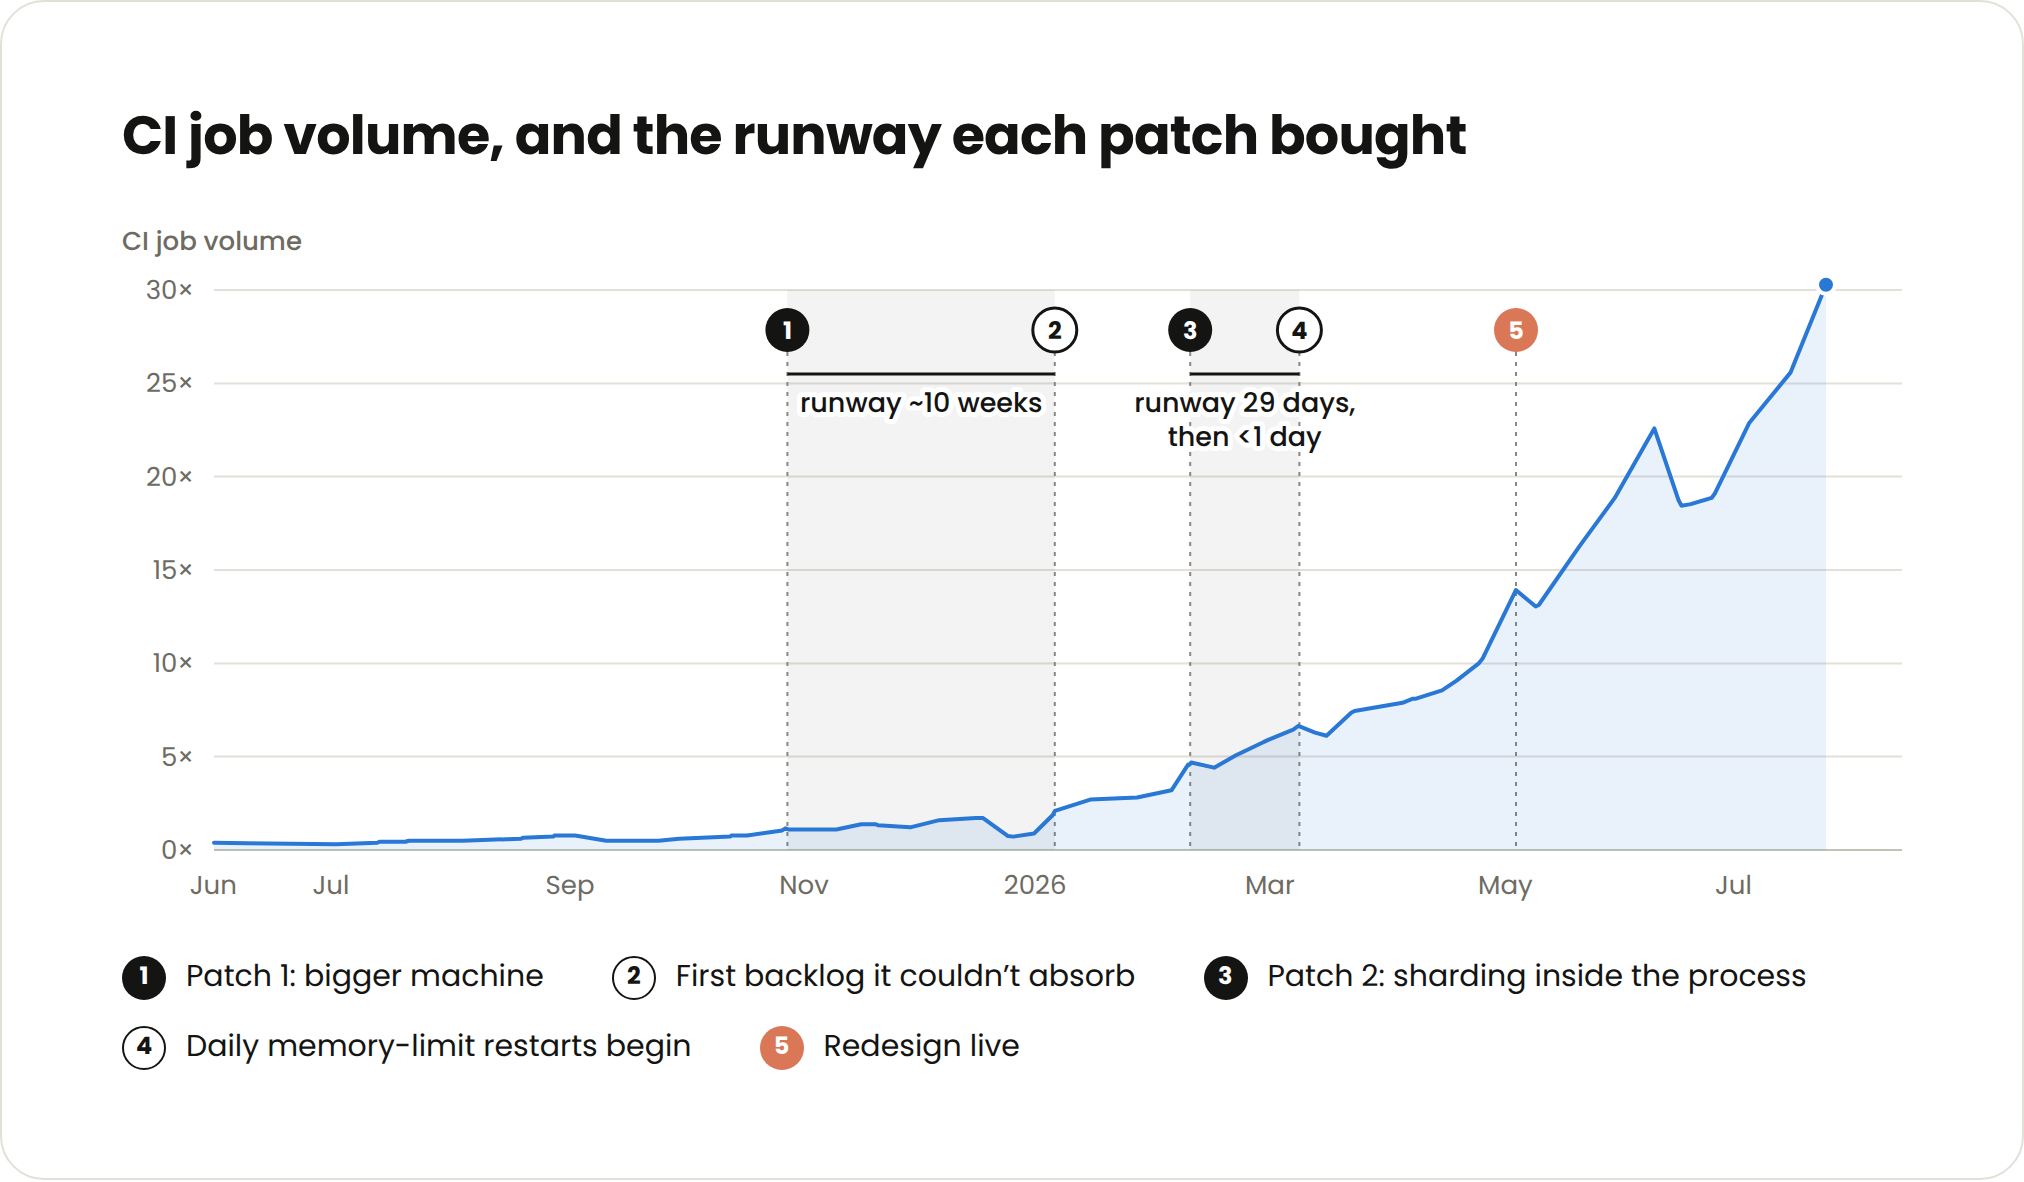
В этой статье я расскажу, как мы масштабировали нашу службу анализа влияния тестов в Anthropic, и о том уроке, который я усвоил на горьком опыте: всегда планируйте с учётом экспоненциального роста. Конкретные методы масштабирования — покупка более мощных машин, распараллеливание процессов или перезапуск службы — да, этот метод всё ещё работает на удивление хорошо — являются распространёнными и не теми выводами, которые следует вынести из этой статьи.
Суть в том, что каждая из этих техник выиграла лишь часть того времени, которое они выигрывали год назад. С другой стороны, переработка и полное перепроектирование сервиса теперь также занимают лишь часть времени и гораздо более устойчивы, поскольку написание кода больше не является узким местом.
Чем лучше Вы сможете предвидеть эту нагрузку и спланировать, как Ваша архитектура будет развиваться вместе с ней, тем меньше времени Вы потратите на полумеры.
Архитектура анализа влияния тестов
Многие мои коллеги работают в организациях, где каждый тест по-прежнему запускается при каждом изменении. Это работает до определённого момента, но не масштабируется: барьеры CI становятся всё более долгими, дорогими и ненадёжными.
Кроме того, люди отлично определяют, какие сбои тестов к ним не относятся, тогда как агентам потребуется больше контекста и указаний. Когда они получают конкретный набор допустимых тестов, они могут более эффективно самостоятельно проверять себя и итеративно улучшаться.
В Anthropic мы создали детерминированный сервис анализа влияния тестов, или выбора тестов, который определяет, какие тесты запускать при каждом изменении, на основе прошлых результатов и релевантности пакетов. Это не редкая практика, и существует категория поставщиков с предложениями в этой области.
Наша служба зависит от того, чтобы два детерминированных компонента оставались синхронизированными:
- «Слушатель» записывает результаты тестов из каждого запуска непрерывной интеграции.
- «Селектор» читает историю результатов тестов и определяет, какие тесты запускаются для каких открытых запросов на включение изменений.
Это эффективно, но когда каждую секунду выполняется несколько заданий непрерывной интеграции, слушатель начинает всё больше отставать от очереди запросов на включение изменений. Для жизненного цикла разработки программного обеспечения, ориентированного на искусственный интеллект даже небольшая задержка может иметь большое влияние. Например, 20 минут отставания слушателя могут означать, что десятки тысяч обновлений тестов не применяются к селектору.
- Если в основную ветку попадает плохое изменение, тест начнёт завершаться с ошибкой у всех остальных, вызывая множество ненужных расследований.
- Если зависимость начинает работать нестабильно, нестабильные ошибки начинают блокировать слияния.
- Если тест исправляется или добавляется новый, он не будет запускаться, пока слушатель не наверстает отставание, создавая риск регрессии.
Всё это выполнялось как единый процесс, потому что ведение истории выполнения для каждого теста означало, что один записывающий процесс должен был применять результаты. Эта архитектура версии 0 не позволяла нам горизонтально шардировать систему.
Тернистый путь к переработке архитектуры
К октябрю прошлого года сервис уже начал демонстрировать признаки перегрузки, и нас вызывали по пейджеру два дня подряд.
Заплатка 1: Более мощная машина
Первое исправление было простым: мы удвоили количество ядер, на которых работал сервис. Мы также знали, что это будет временной мерой.
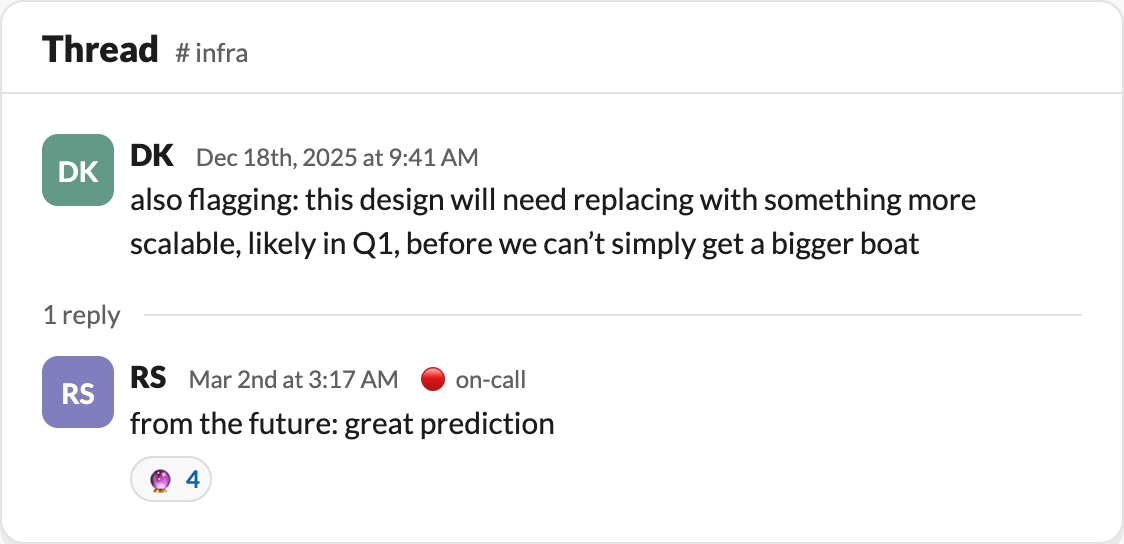
Даже когда линия тренда была очевидна, ответственность оставалась неясной. Никто не хотел брать на себя ещё один компонент инфраструктуры. Кроме того, у команды непрерывной интеграции были более важные задачи.
Заплатка 2: Шардирование
К этому моменту нас довольно часто вызывали по пейджеру из-за накапливающейся задержки в слушателе этого сервиса. Чтобы продвинуть некоторые долгосрочные исправления, я начал длительный сеанс во внутренней версии Claude Tag, предназначенной для мониторинга сервиса. Каждый раз, когда задержка слушателя превышала 50 000 заданий, Claude отправлял мне уведомление и возобновлял наш разговор о дальнейших шагах.
Это продолжалось месяцами, и было полезно не приходилось постоянно напоминать ему о прошлых попытках или контексте. Claude часто выступал за капитальную переработку, но обычно мы останавливались на очередном патче.
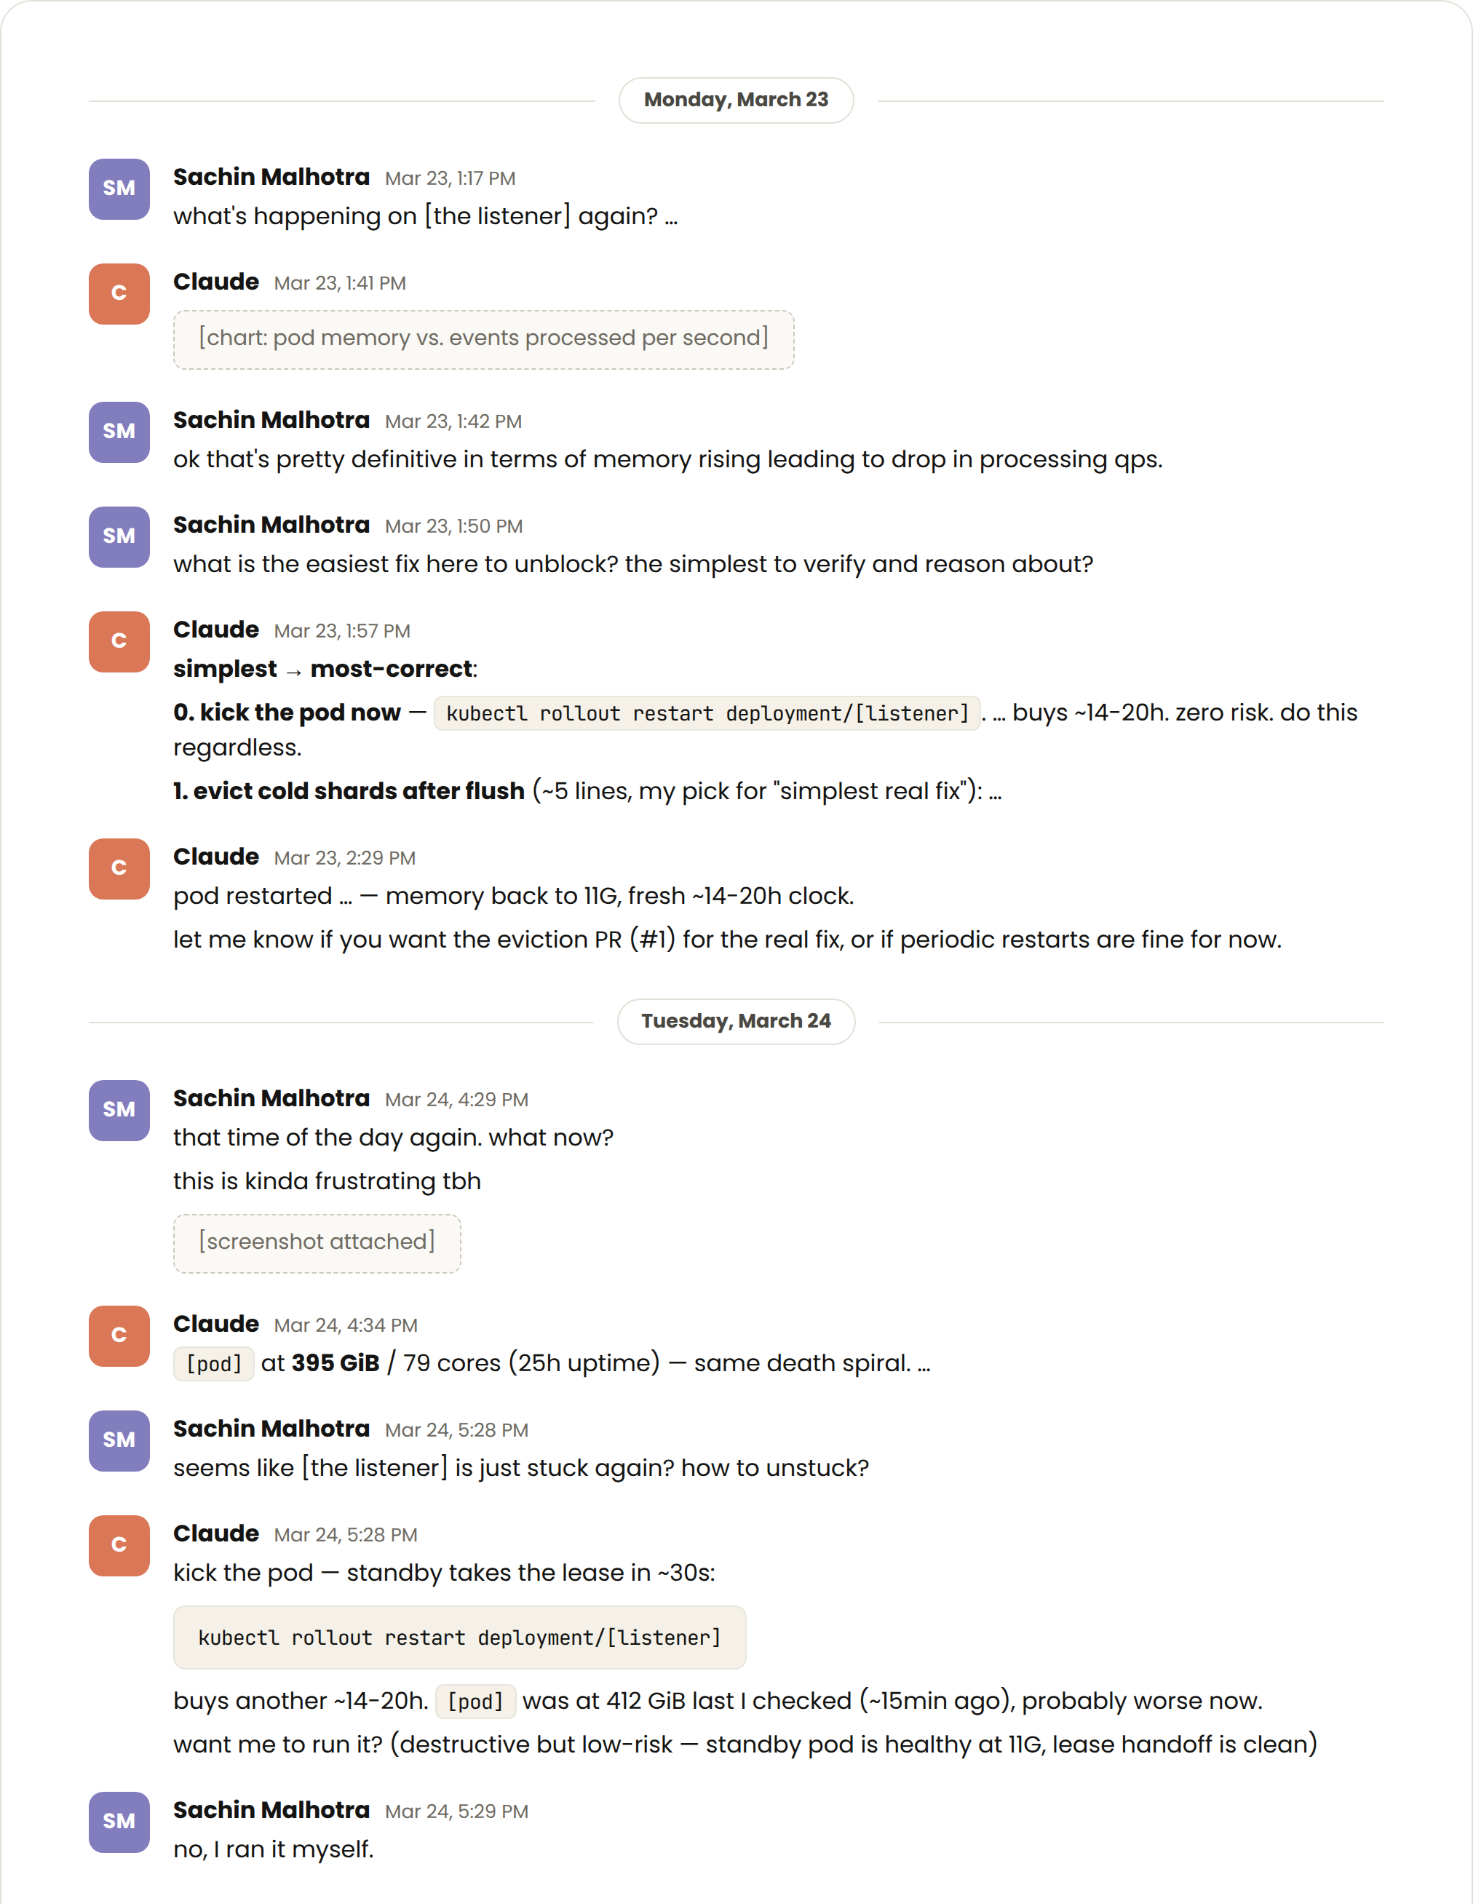
В феврале экспоненциальный рост заданий непрерывной интеграции снова начал нагружать сервис. На этот раз мы решили распараллелить работу.
Слушателю не требовался один модуль записи, чтобы правильно упорядочивать результаты тестов, — ему требовался один модуль записи на пакет, чтобы правильно упорядочивать результаты тестов для каждого раздела нашей кодовой базы. Claude сгенерировал для нас код, чтобы разделить состояние каждого пакета на сегмент с собственным воркером.
Мы также знали, что это исправление будет недолговечным, но не предполагали, что оно даст нам лишь 29 дней.
Патч 3: Ежедневные перезапуски
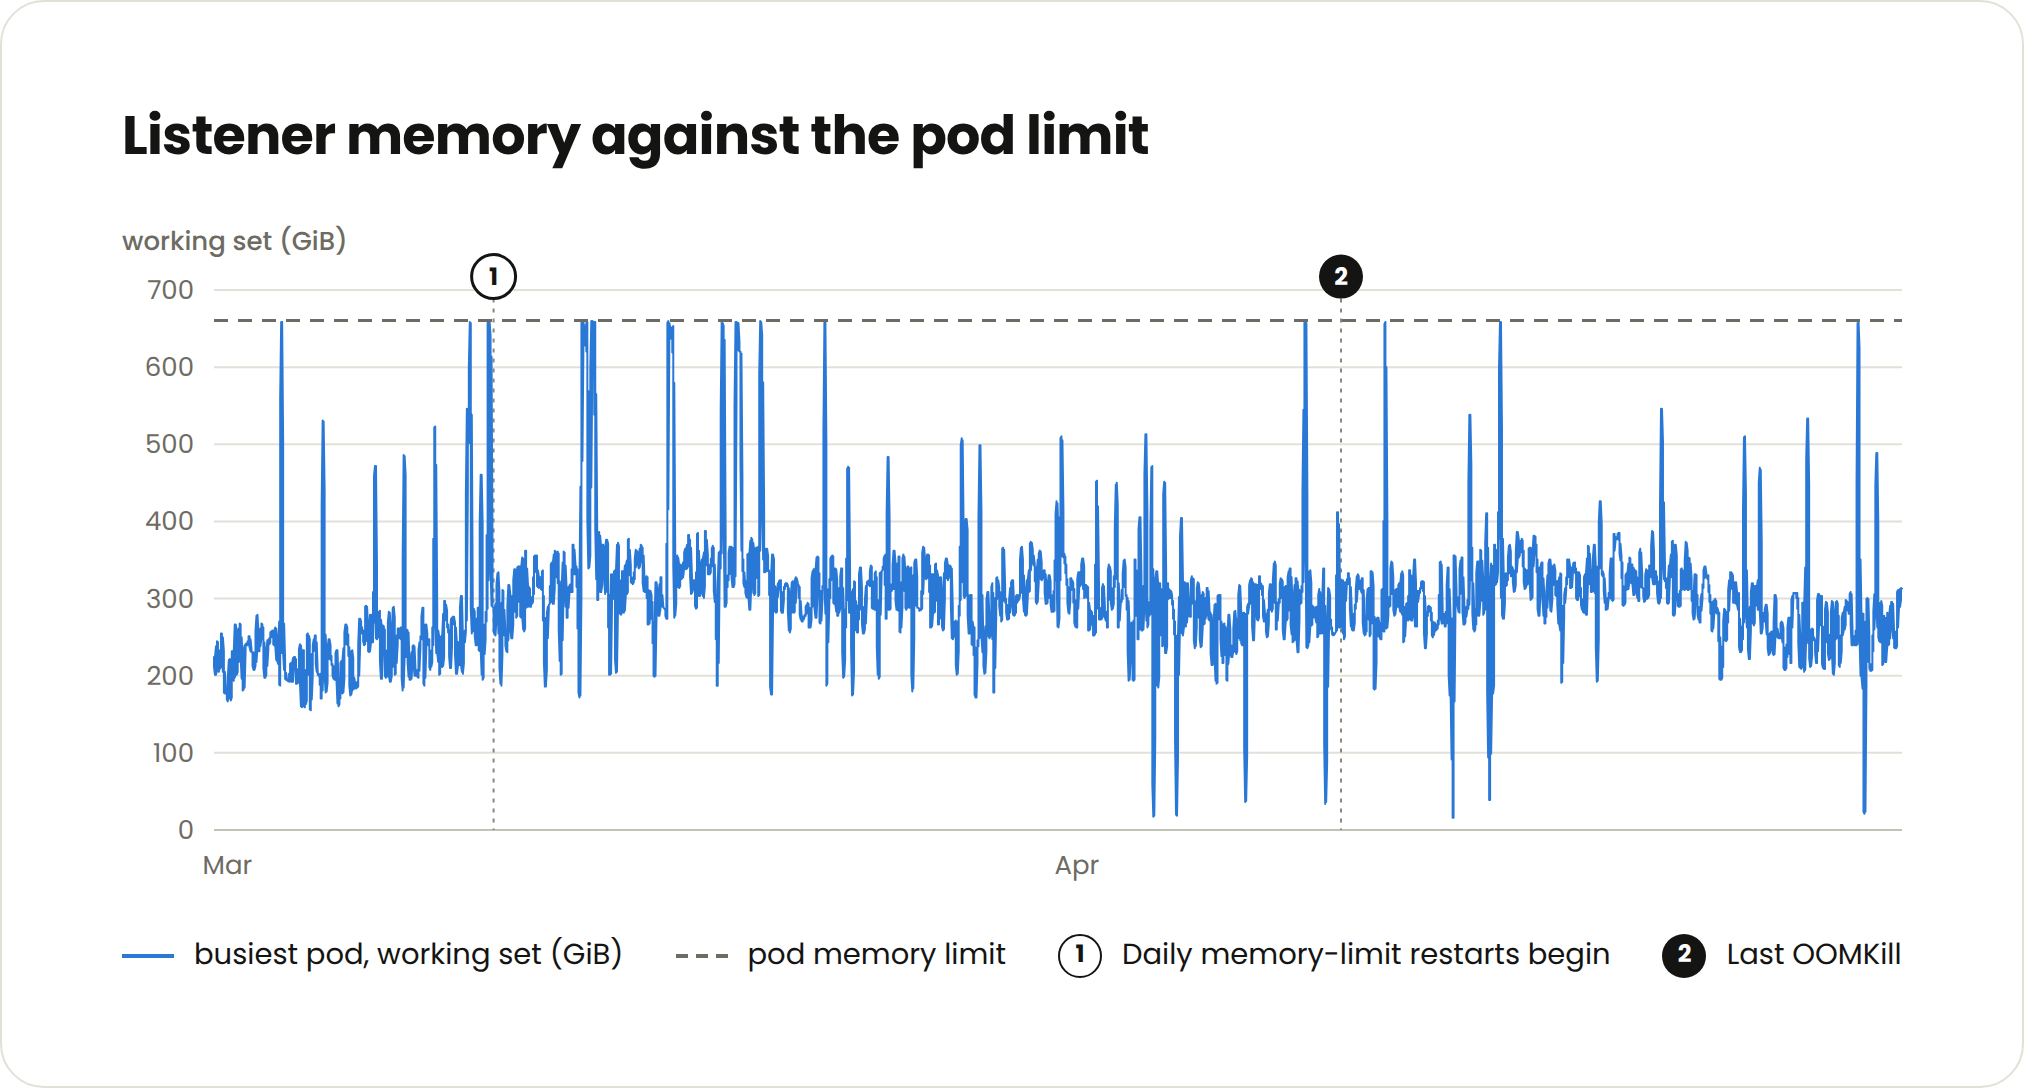
В марте процесс достигал своего лимита памяти к середине дня в большинство будних дней. Снова мы искали быстрые исправления, но:
- Мы нашли лишь четыре ошибки.
- Замена аллокатора памяти в качестве быстрого хака ничего не дала. Мы пытались оптимизировать сборку мусора, но это не было настоящим решением.
- Мы не хотели рисковать, профилируя память единственного экземпляра, уже находившегося под высокой нагрузкой.
- Перезапуск давал нам меньше одного дня.
Мы также обнаружили, что ежедневные перезапуски приводили к тому, что сервис постепенно всё сильнее отставал. Когда он отставал более чем на час, что происходило несколько раз, слушатель не записывал огромное количество результатов задач.
Чтобы внести ясность, это не означает, что непрерывная интеграция никогда не запускалась для этих запросов на включение изменений или что непроверенный код отправлялся в эксплуатационную среду. Это означало, что слушатель не получал некоторые результаты, из-за чего наш компонент выбора тестов использовал устаревшие данные, чтобы решать, что запускать, а что не запускать для запросов на включение изменений. В основном это приводило к тому, что мы запускали тесты, которые уже были крайне нестабильными или массово завершались с ошибкой по всем направлениям.
Переработка
Пришло время переработать сервис, и мы последовали совету Claude: мы предоставили сервису выбора тестов базу данных, точнее говоря, хранилище данных в памяти. Тем самым мы фактически перенесли значительную часть обработки в памяти, которую раньше выполнял одиночный экземпляр.
Теперь любой рабочий процесс слушателя может обработать любой результат, добавить его в журнал во внутрипамятном хранилище и продолжить работу, ничего не удерживая в памяти — без состояния и, следовательно, с возможностью горизонтального масштабирования. Небольшой отдельный процесс-потребитель каждые несколько секунд сворачивает журнал в историю по каждому тесту, а селектор может быстро находить релевантную историю результатов.
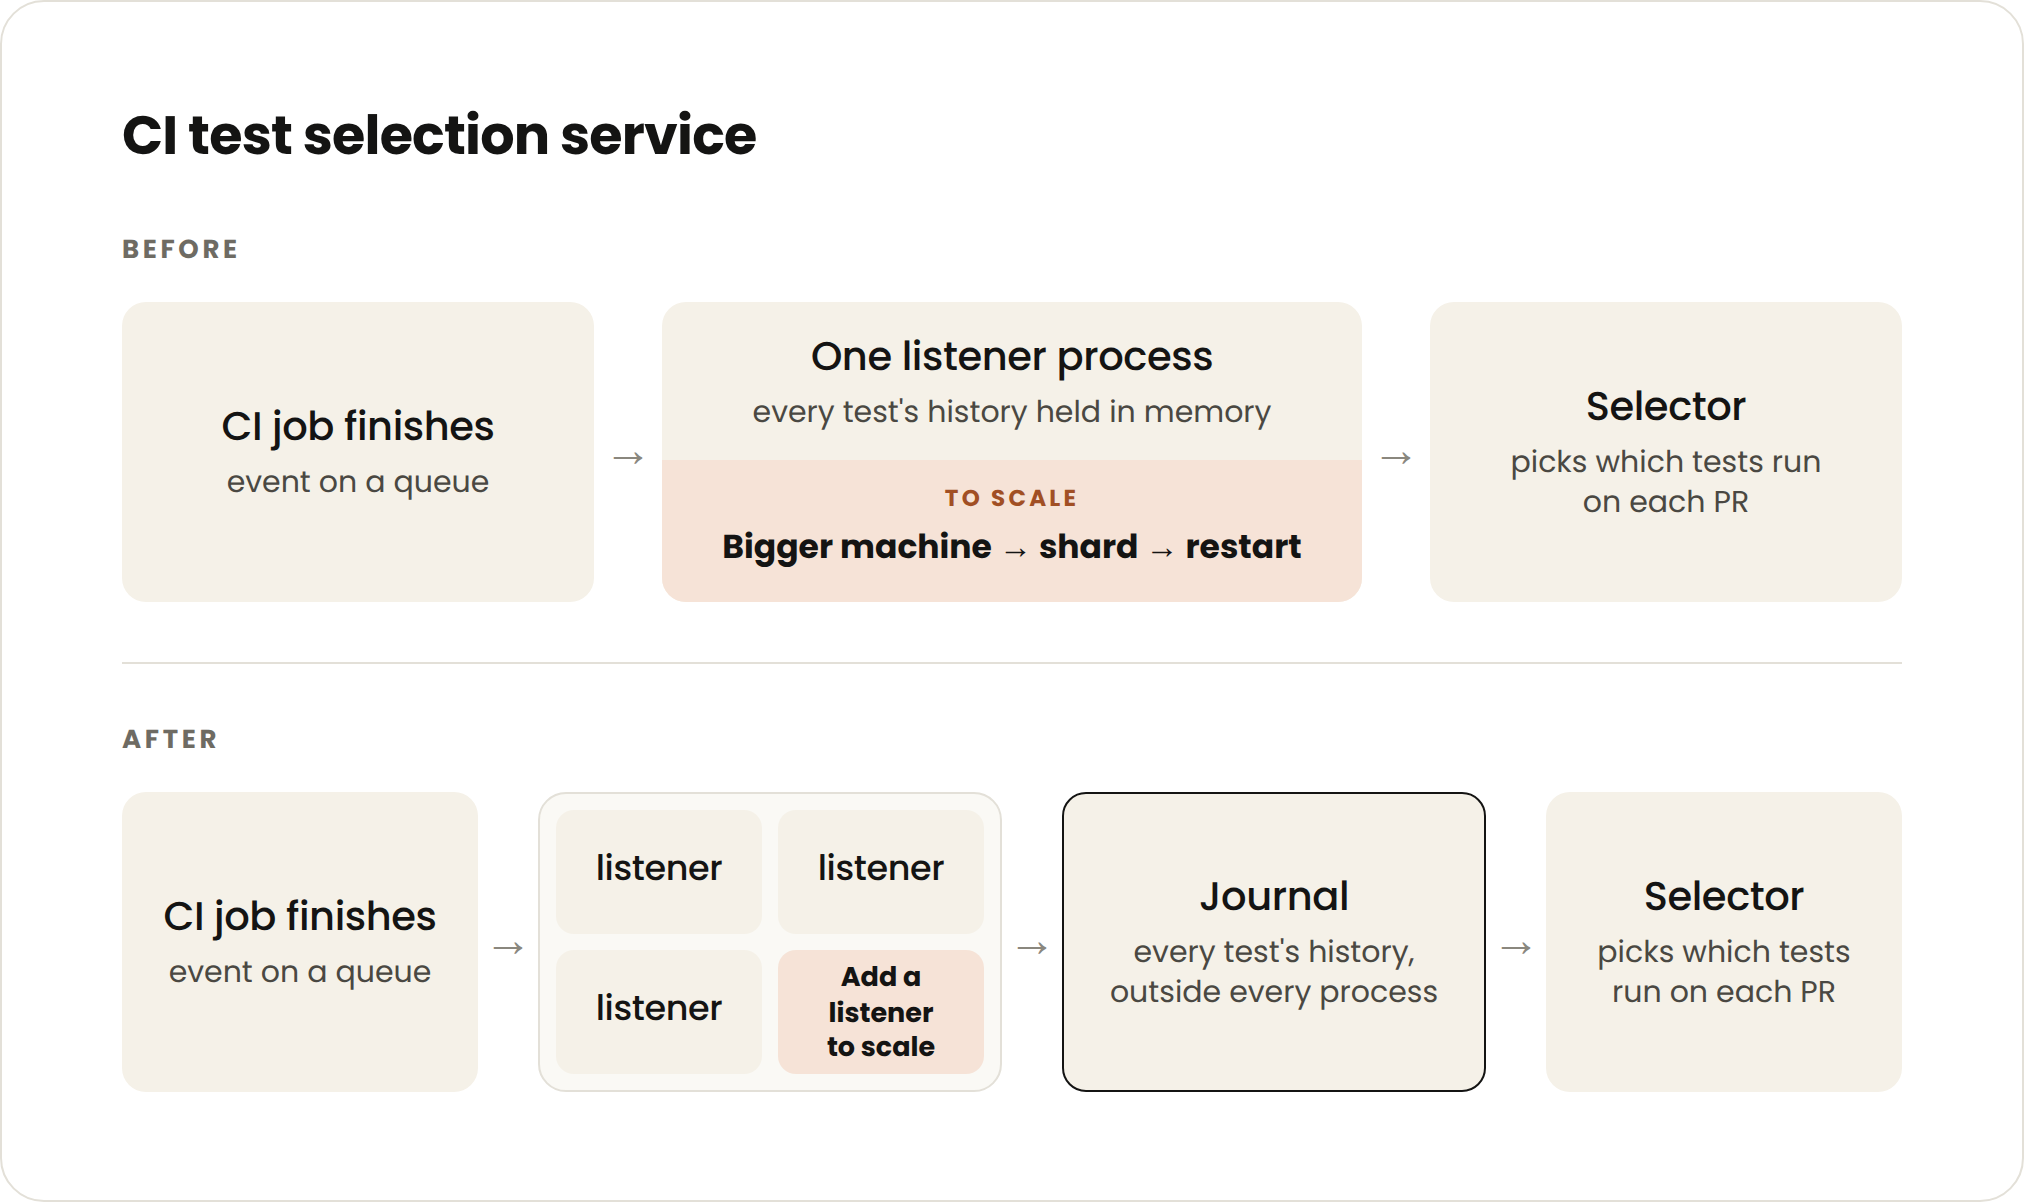
Эта распределённая архитектура дороже в эксплуатации, но её гораздо проще масштабировать и профилировать по памяти, чем нестабильный одиночный экземпляр. Этот проект занял три недели у одного инженера. Год назад это было бы ближе к кварталу.
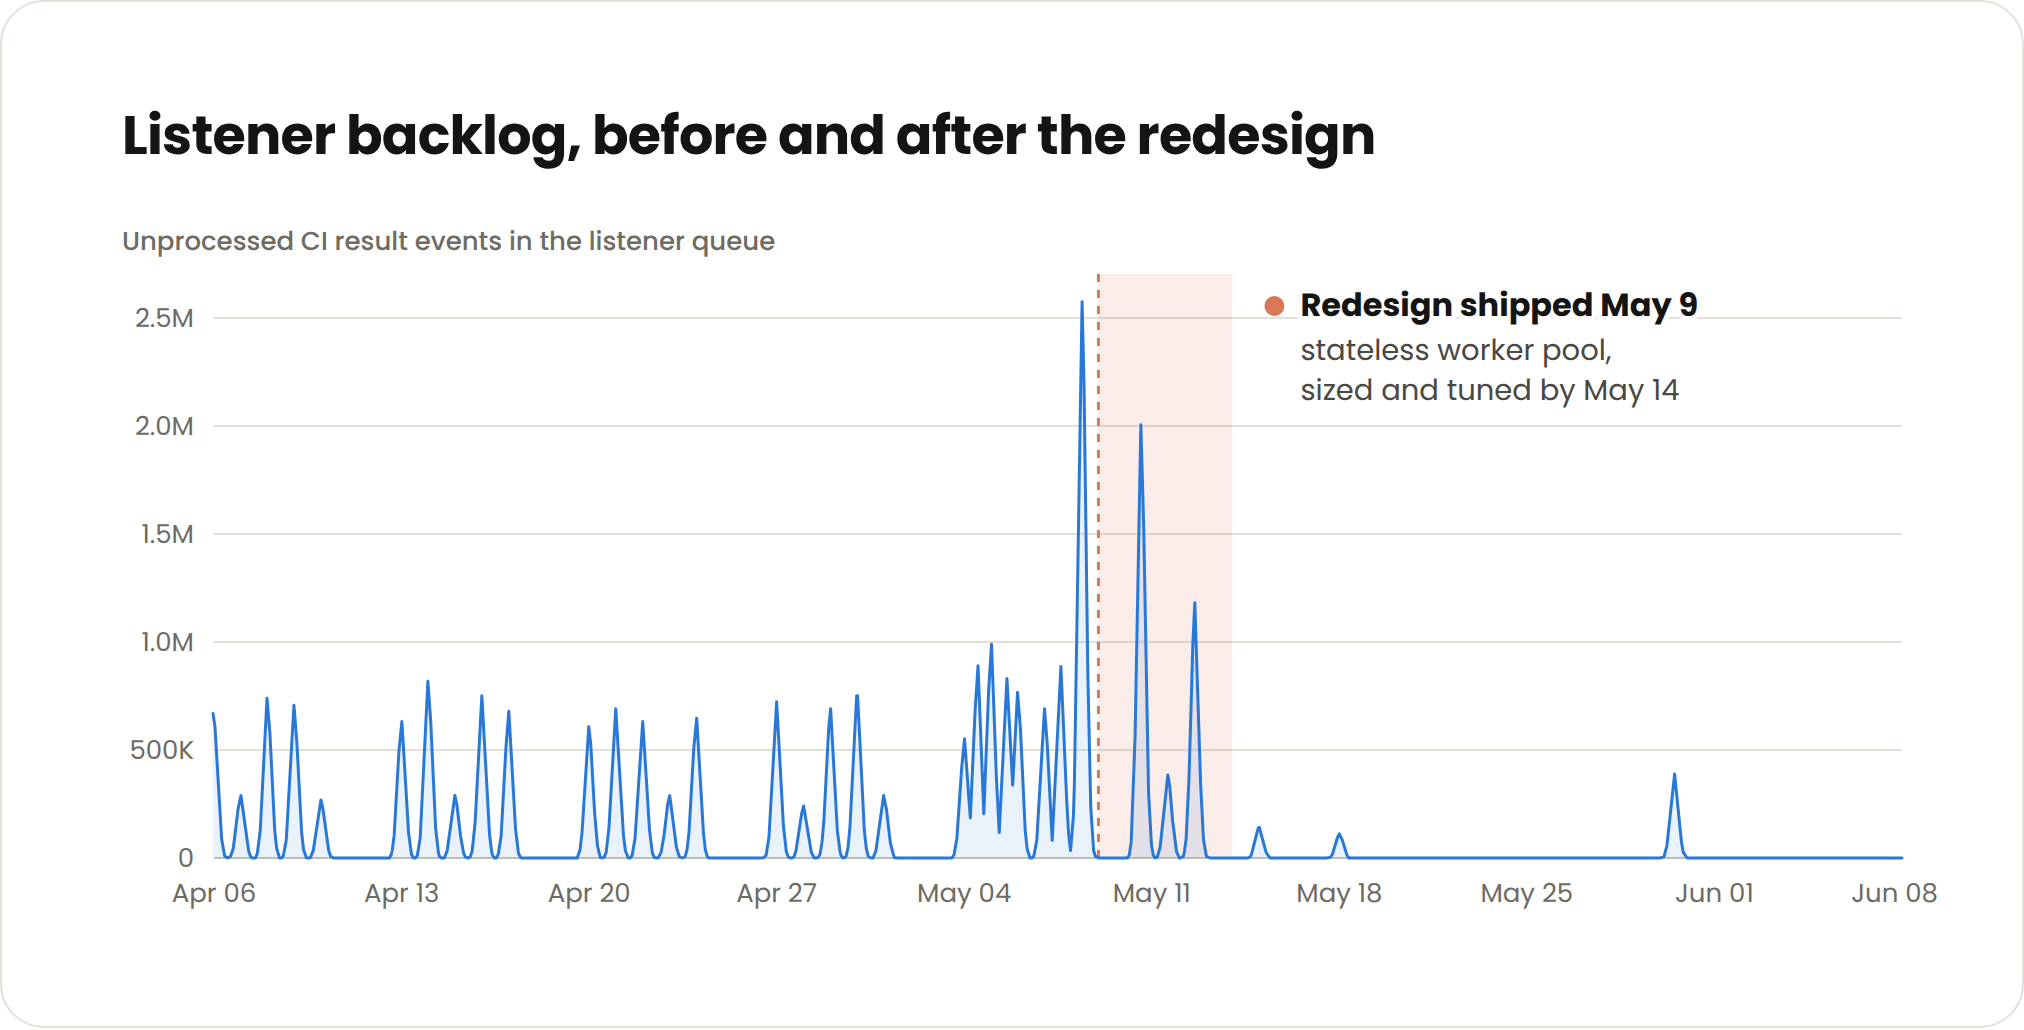
Была проведена некоторая тонкая настройка — размера журнала и количества рабочих процессов, — которую Claude выполнил в значительной степени автономно, но с тех пор наш сервис остаётся стабильным.
Что я сделал бы иначе
Если бы меня отправили назад во времени в октябрь 2025 года, я бы иначе подошёл к этому и другим проектам, зная то, что знаю сейчас.
Первое различие заключается в том, что я бы учитывал экспоненциальный рост, связанный с ИИ. Количество заданий CI растёт экспоненциально по мере увеличения среднего числа агентов на инженера и совершенствования ускоренного утверждения PR.
Со временем это изменило характер PR в Anthropic, поскольку Claude предпочитает более мелкие, детализированные PR — ещё одна веская причина не запускать каждый тест для каждого PR. Это привело к увеличению числа заданий CI за день. Кроме того, минимальный уровень активности повышается, поскольку агенты отправляют изменения ночью и в выходные, однако активность остаётся неравномерной, так как инженеры-люди по-прежнему создают и утверждают значительную часть PR.
Мой совет инженерным командам: независимо от того, разрабатываете Вы решение самостоятельно или покупаете его, исходите из того, что через два квартала Ваша архитектура будет работать при нагрузке, увеличенной в 25 раз. Избыточное проектирование как концепция начинает постепенно уходить в прошлое или, по крайней мере, требования к нему становятся значительно выше. Теперь Вы можете закладывать в проекты версии 0 предполагаемый масштаб, увеличенный в 10–20 раз, если Ваш бюджет это позволяет.
Инструментируйте свои сервисы, чтобы они стали глазами и ушами Claude. Это позволяет Claude гораздо лучше и быстрее, чем мы могли бы вручную, постепенно улучшать систему и исправлять проблемы. В частности, убедитесь, что количество поступающих заданий непрерывной интеграции равно количеству исходящих.
С самого начала не храните состояние в процессе. Я также избегал бы запуска любого критически важного сервиса в одном экземпляре, если Вы не можете измерять его и любые канареечные изменения. Непрерывная интеграция развивается слишком быстро, чтобы действовать иначе.
Дополнительные ресурсы по непрерывной интеграции
Я также написал о том, как мы ускорили дежурство по непрерывной интеграции с использованием Claude Tag (бета-версия).
Источник
Agentic coding is straining CI. Here’s how we scaled test impact analysis at Anthropic
https://claude.com/blog/agentic-coding-is-straining-ci-heres-how-we-scaled-test-impact-analysis-at-anthropicРедактор русской версии: Пётр Смывин.
Разбор подготовлен 15 сентября 2026.