Полный перевод исследования Anthropic на русский. Оригинал — по ссылке.
ПОДКАСТ
В этом посте мы рассказываем, как Claude сделал используемые учёными для предсказания и проектирования биомолекул модели с открытым исходным кодом быстрее и эффективнее с точки зрения использования памяти. Claude, работая в рамках Claude Science, оптимизировал более 30 таких моделей менее чем за четыре недели, ускорив их работу в среднем примерно в 4 раза. Он также создал режим низкого потребления памяти, который позволяет точно предсказывать биомолекулярные системы размером более 10 000 токенов (аминокислот, нуклеотидов и атомов из малых молекул и ионов) на одном узле GPU NVIDIA. Мы публикуем весь оптимизированный код с открытым исходным кодом и объявляем конкурс по проектированию белков, проводимый совместно с Adaptyv Bio и поддержанный кредитами Claude на сумму до 1 миллиона долларов США, а также лабораторной валидацией более 5 000 разработок.
Недавно мы поделились результатами, демонстрирующими способности Claude проектировать белковые связывающие молекулы de novo посредством координации на экспертном уровне моделей с открытым исходным кодом для проектирования белков и предсказания их структуры. Связывающие молекулы de novo — это небольшие, вычислительно спроектированные белки, которые прочно присоединяются к конкретной целевой молекуле, чтобы активировать, блокировать или доставлять к ней что-либо.
Хотя это стало обнадёживающей демонстрацией научных возможностей искусственного интеллекта и ранним шагом на пути к развитию разработки лекарственных препаратов, для этого потребовалось больше ресурсов, чем доступно подавляющему большинству разработчиков белков. Мы позволили Claude потратить до 10 0 долларов США на каждую цель на платформе инфраструктуры искусственного интеллекта Modal, что примерно эквивалентно 2 0 часам работы графических процессоров NVIDIA H100.
Чтобы сделать такие исследования более доступными, мы начали изучать оптимизации инференса для более эффективной работы этих моделей. В качестве раннего результата этих оптимизаций Claude Mythos 5.1 ускорил семь биологических моделей с открытым исходным кодом, позволив им работать до 2,5 раза быстрее.
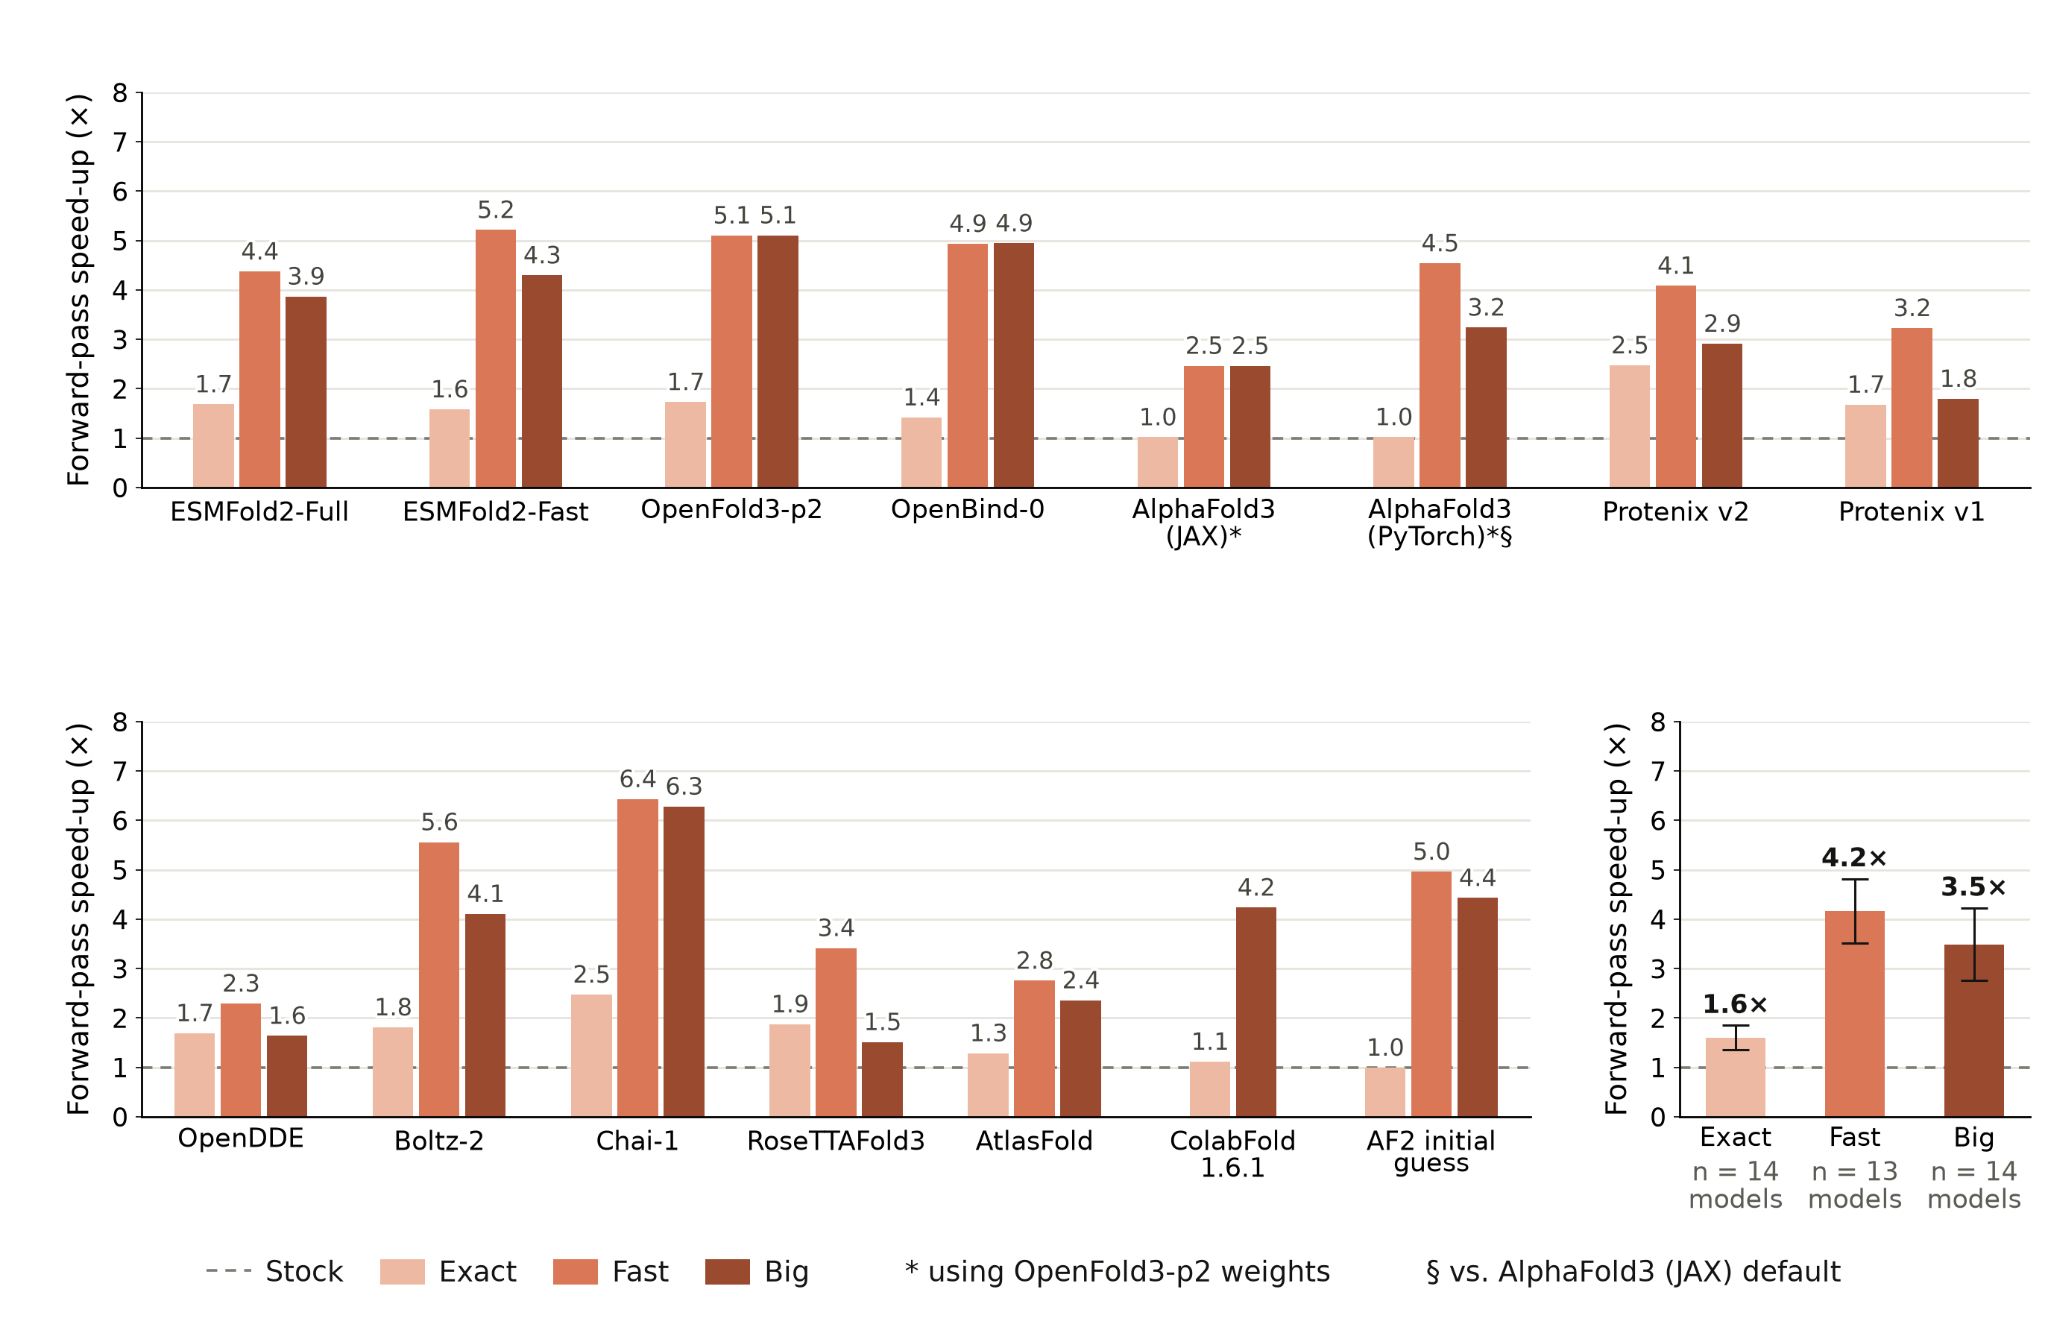
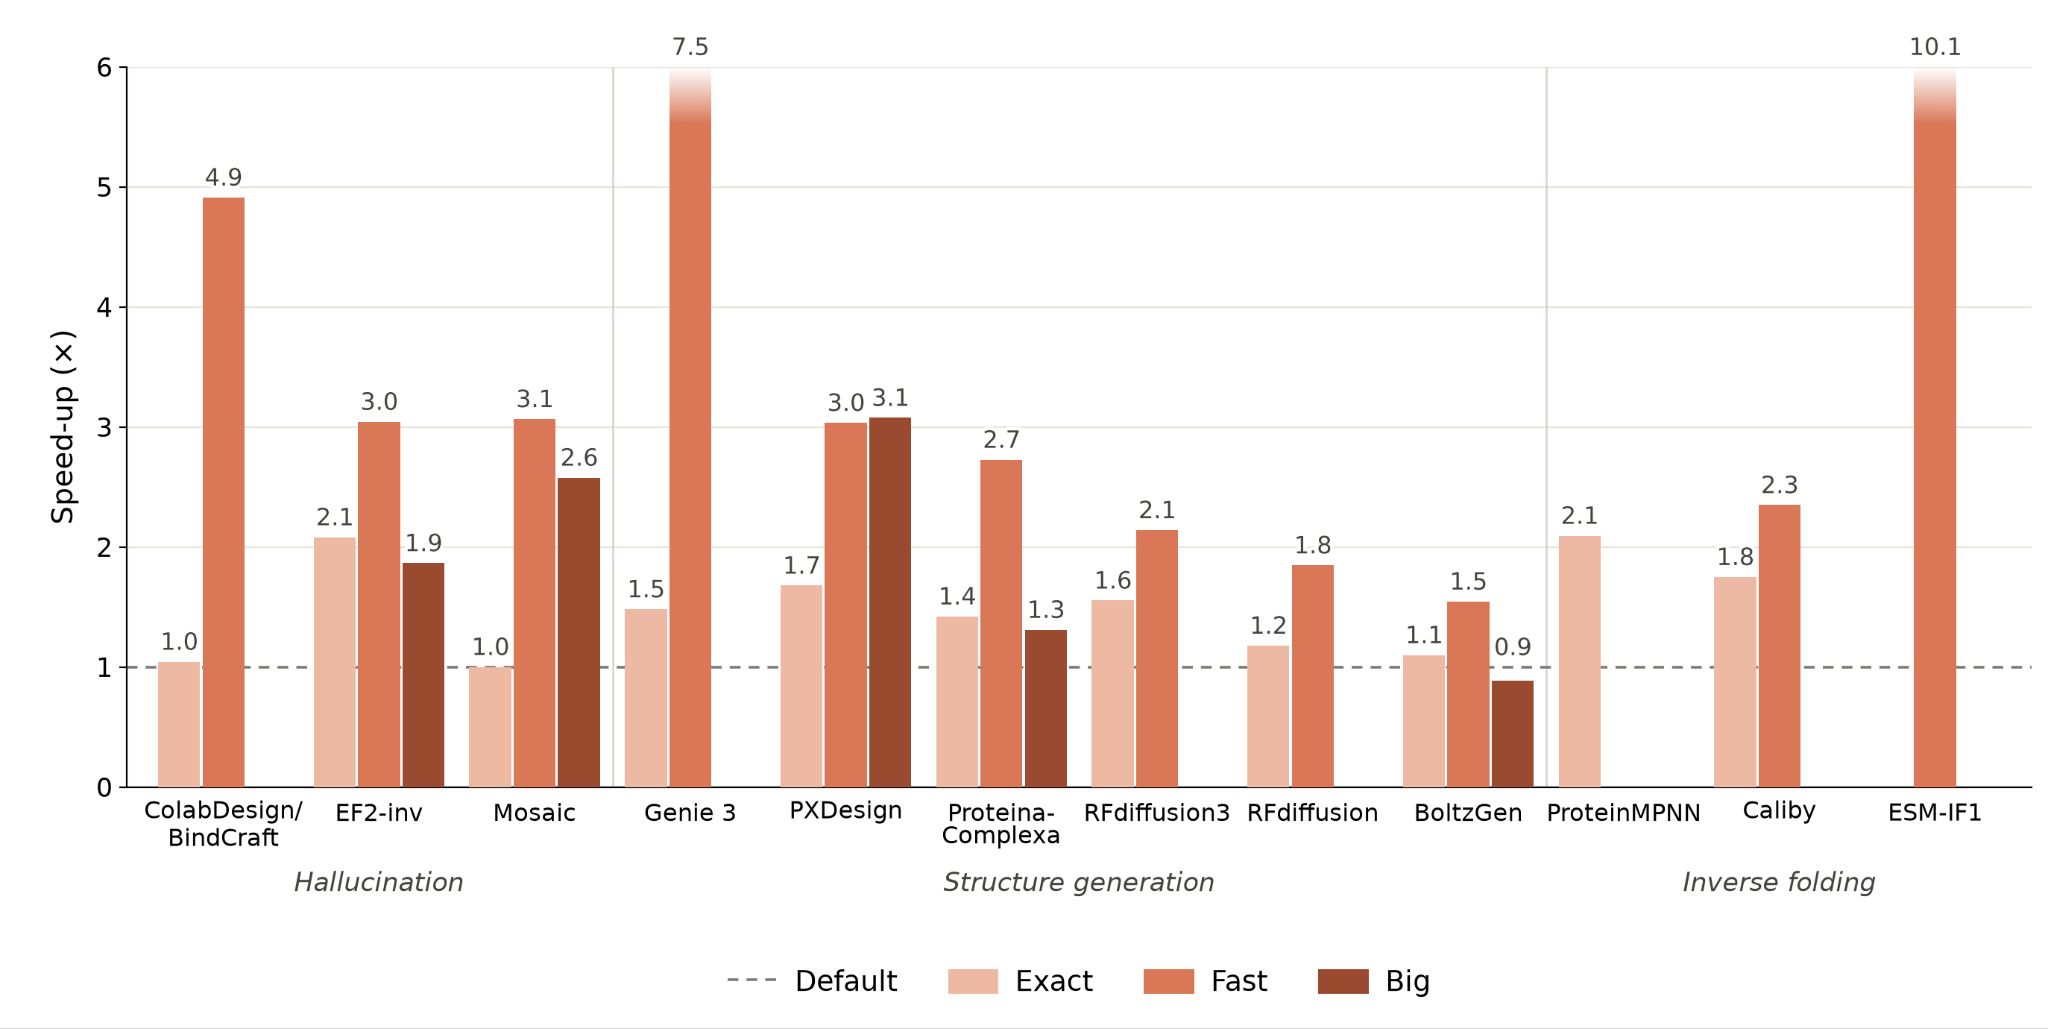
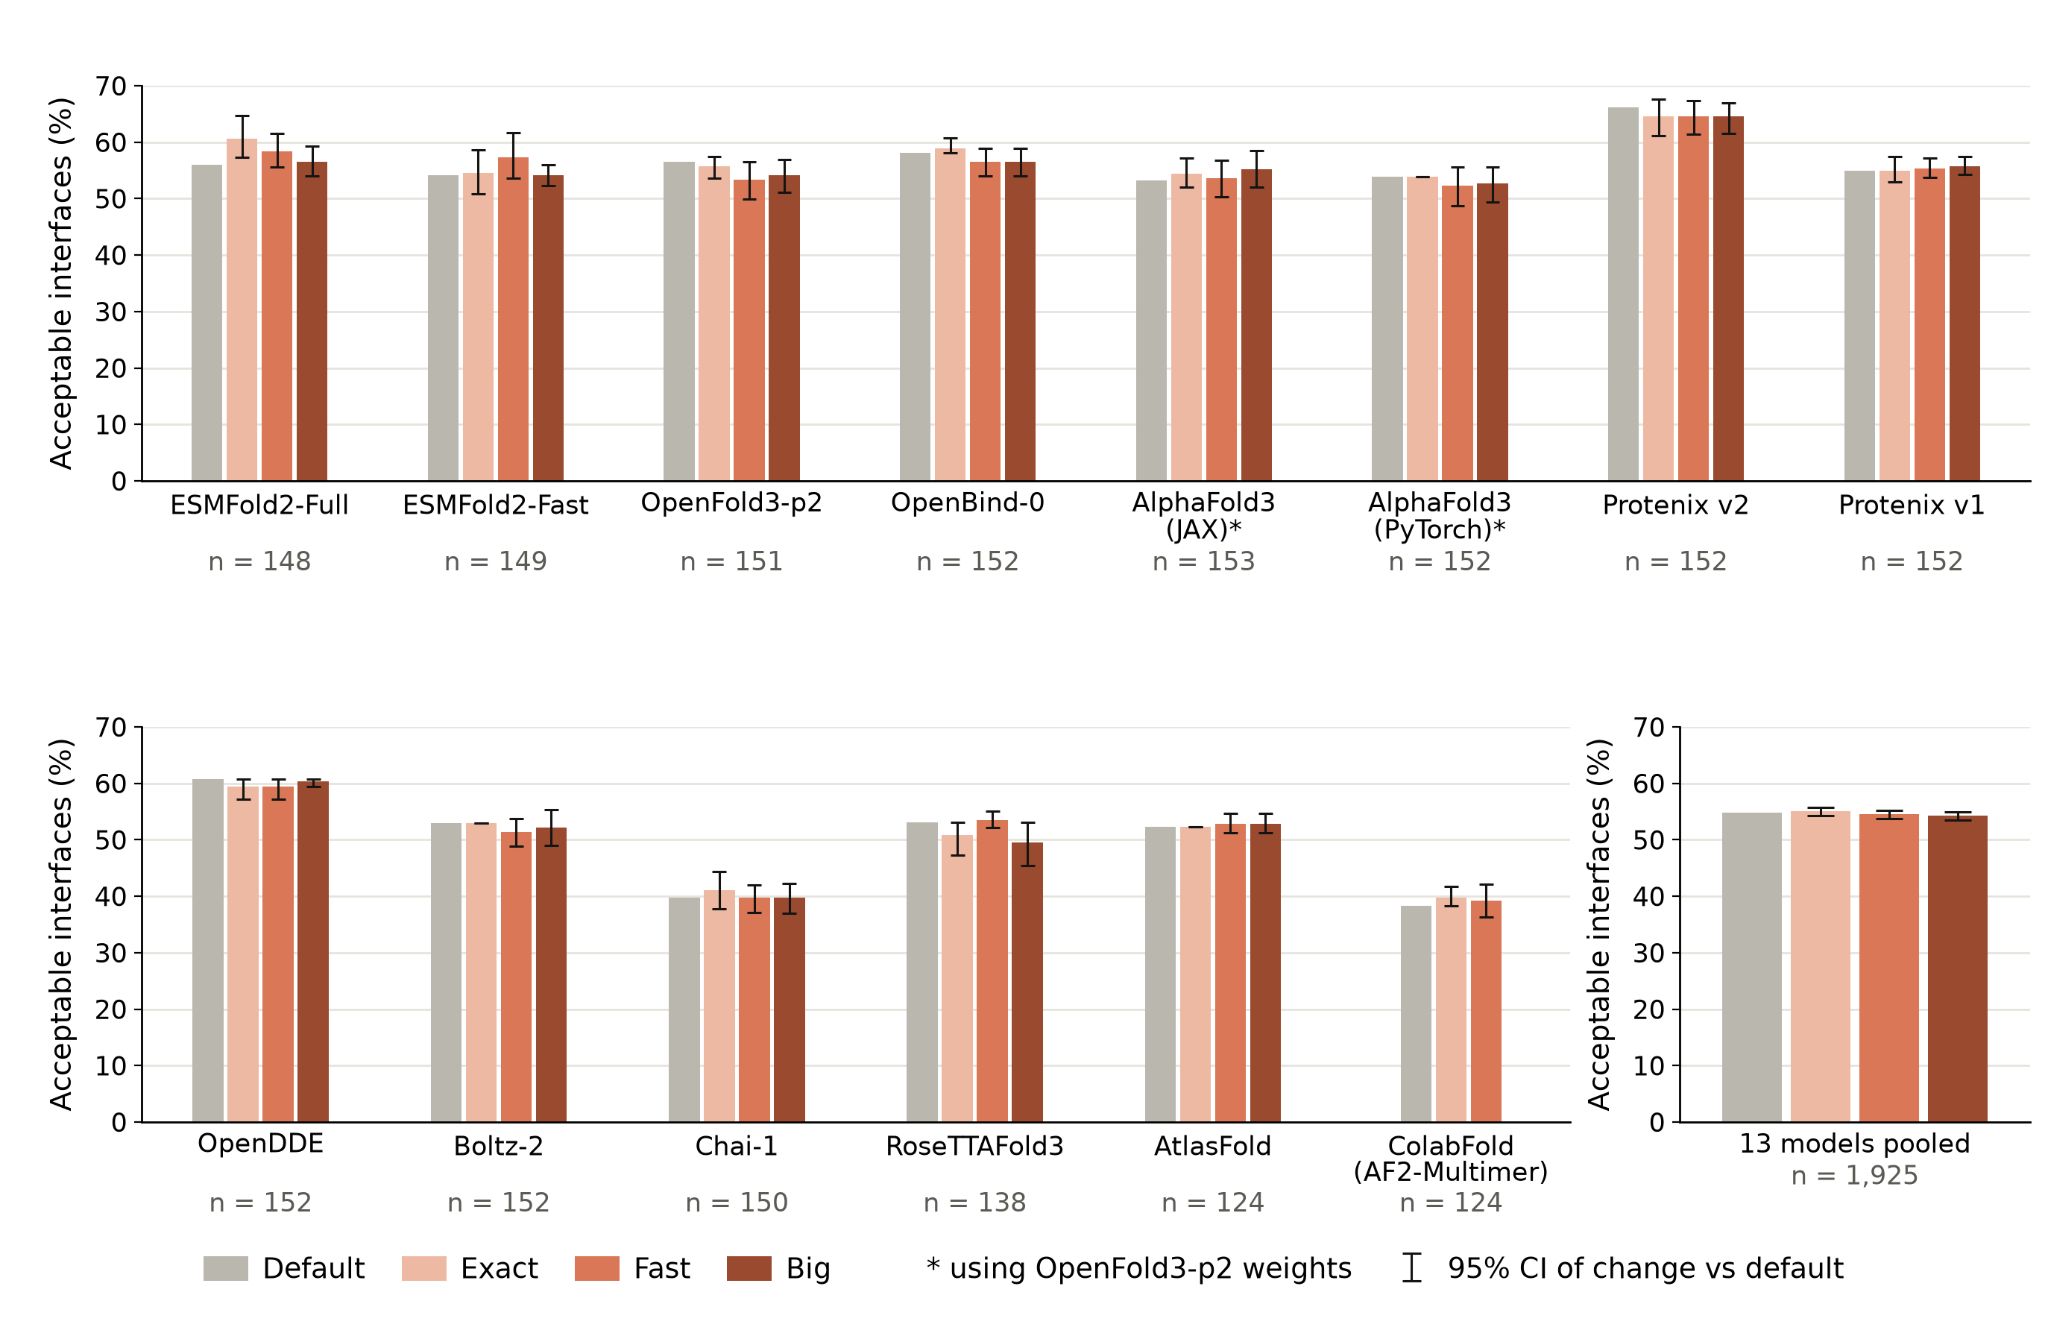
Здесь мы представляем новые результаты, демонстрирующие, как внутренняя универсальная исследовательская модель смогла оптимизировать более 30 моделей глубокого обучения, обученных для выполнения различных биологических задач, таких как предсказание структуры и дизайн белков, а также для геномики и языковых моделей белков. В среднем Claude смогла ускорить выполнение таких задач примерно в 4 раза, пожертвовав минимальным количеством точности, и почти в 2 раза при идентичных результатах. Claude также улучшила использование памяти этими моделями, сделав возможным предсказание биомолекулярных систем беспрецедентных размеров. Сочетая эти результаты с упрощениями нашего предыдущего агентного подхода к дизайну белков, мы показываем, что Claude может достигать сопоставимой производительности in silico с результатами, о которых мы ранее сообщали, используя на два порядка меньше часов работы графических процессоров.
Помимо проектирования белков, эти специализированные биологические модели широко используются молекулярными биологами, в том числе для открытия и разработки лекарственных средств. Сегодня мы публикуем в открытом исходном коде оптимизированный код для всех этих моделей (здесь), чтобы более широкое сообщество могло использовать их. Более подробную информацию Вы можете найти в нашем техническом отчёте (здесь).
Чтобы дополнительно поддержать сообщество, мы также выступаем со-спонсорами конкурса по дизайну белков совместно с Adaptyv Bio, которая стала пионером открытых конкурсов по дизайну белков. Мы совместно отобрали пять сложных задач на переднем крае современных возможностей. Вместе с Adaptyv и благодаря щедрым вкладам Modal и Twist Bioscience мы выделяем до 1 миллиона долларов США в виде кредитов Claude и 250 000 долларов США в виде вычислительных кредитов Modal, а также лабораторную валидацию более чем 5 000 дизайнов. Узнайте больше (здесь) и (подайте заявку здесь).
Ускорение моделей предсказания структуры и дизайна белков
Предсказание структуры белка — это задача определения трёхмерной структуры белка только по его последовательности аминокислот. Проектирование белков, в свою очередь, — это процесс создания белка с определённой структурой, функцией или набором свойств. Вместе эти вычислительные инструменты позволяют учёным исследовать ключевые биомолекулярные процессы, например то, как формируются раковые опухоли, и создавать полезные молекулы, такие как лекарства, которые могли бы воздействовать на эти опухоли.
Современные модели предсказания структуры, такие как AlphaFold3, OpenFold3 и Boltz-2, тратят значительную часть времени вычислений и памяти на две операции: треугольное внимание и треугольное умножение, которые работают с тройками токенов. Эти операции позволяют моделировать геометрию биомолекулярных систем, однако они чрезвычайно требовательны к вычислительным ресурсам, поскольку имеют кубическую сложность как по времени вычислений, так и по памяти: удвоение размера системы требует в 8 раз больше времени и памяти, а утроение — в 27 раз больше.
Написание ядер — низкоуровневых программных уровней трансляции для оборудования ускоренных вычислений, такого как графические процессоры, — является стандартным подходом к снижению этих затрат. Учитывая их значимость, треугольное внимание и умножение стали предметом специализированных усилий по разработке ядер — сначала с cuEquivariance от NVIDIA, а позднее с BioNeMo Inference Runtime (BioNeMo-IR) от NVIDIA.
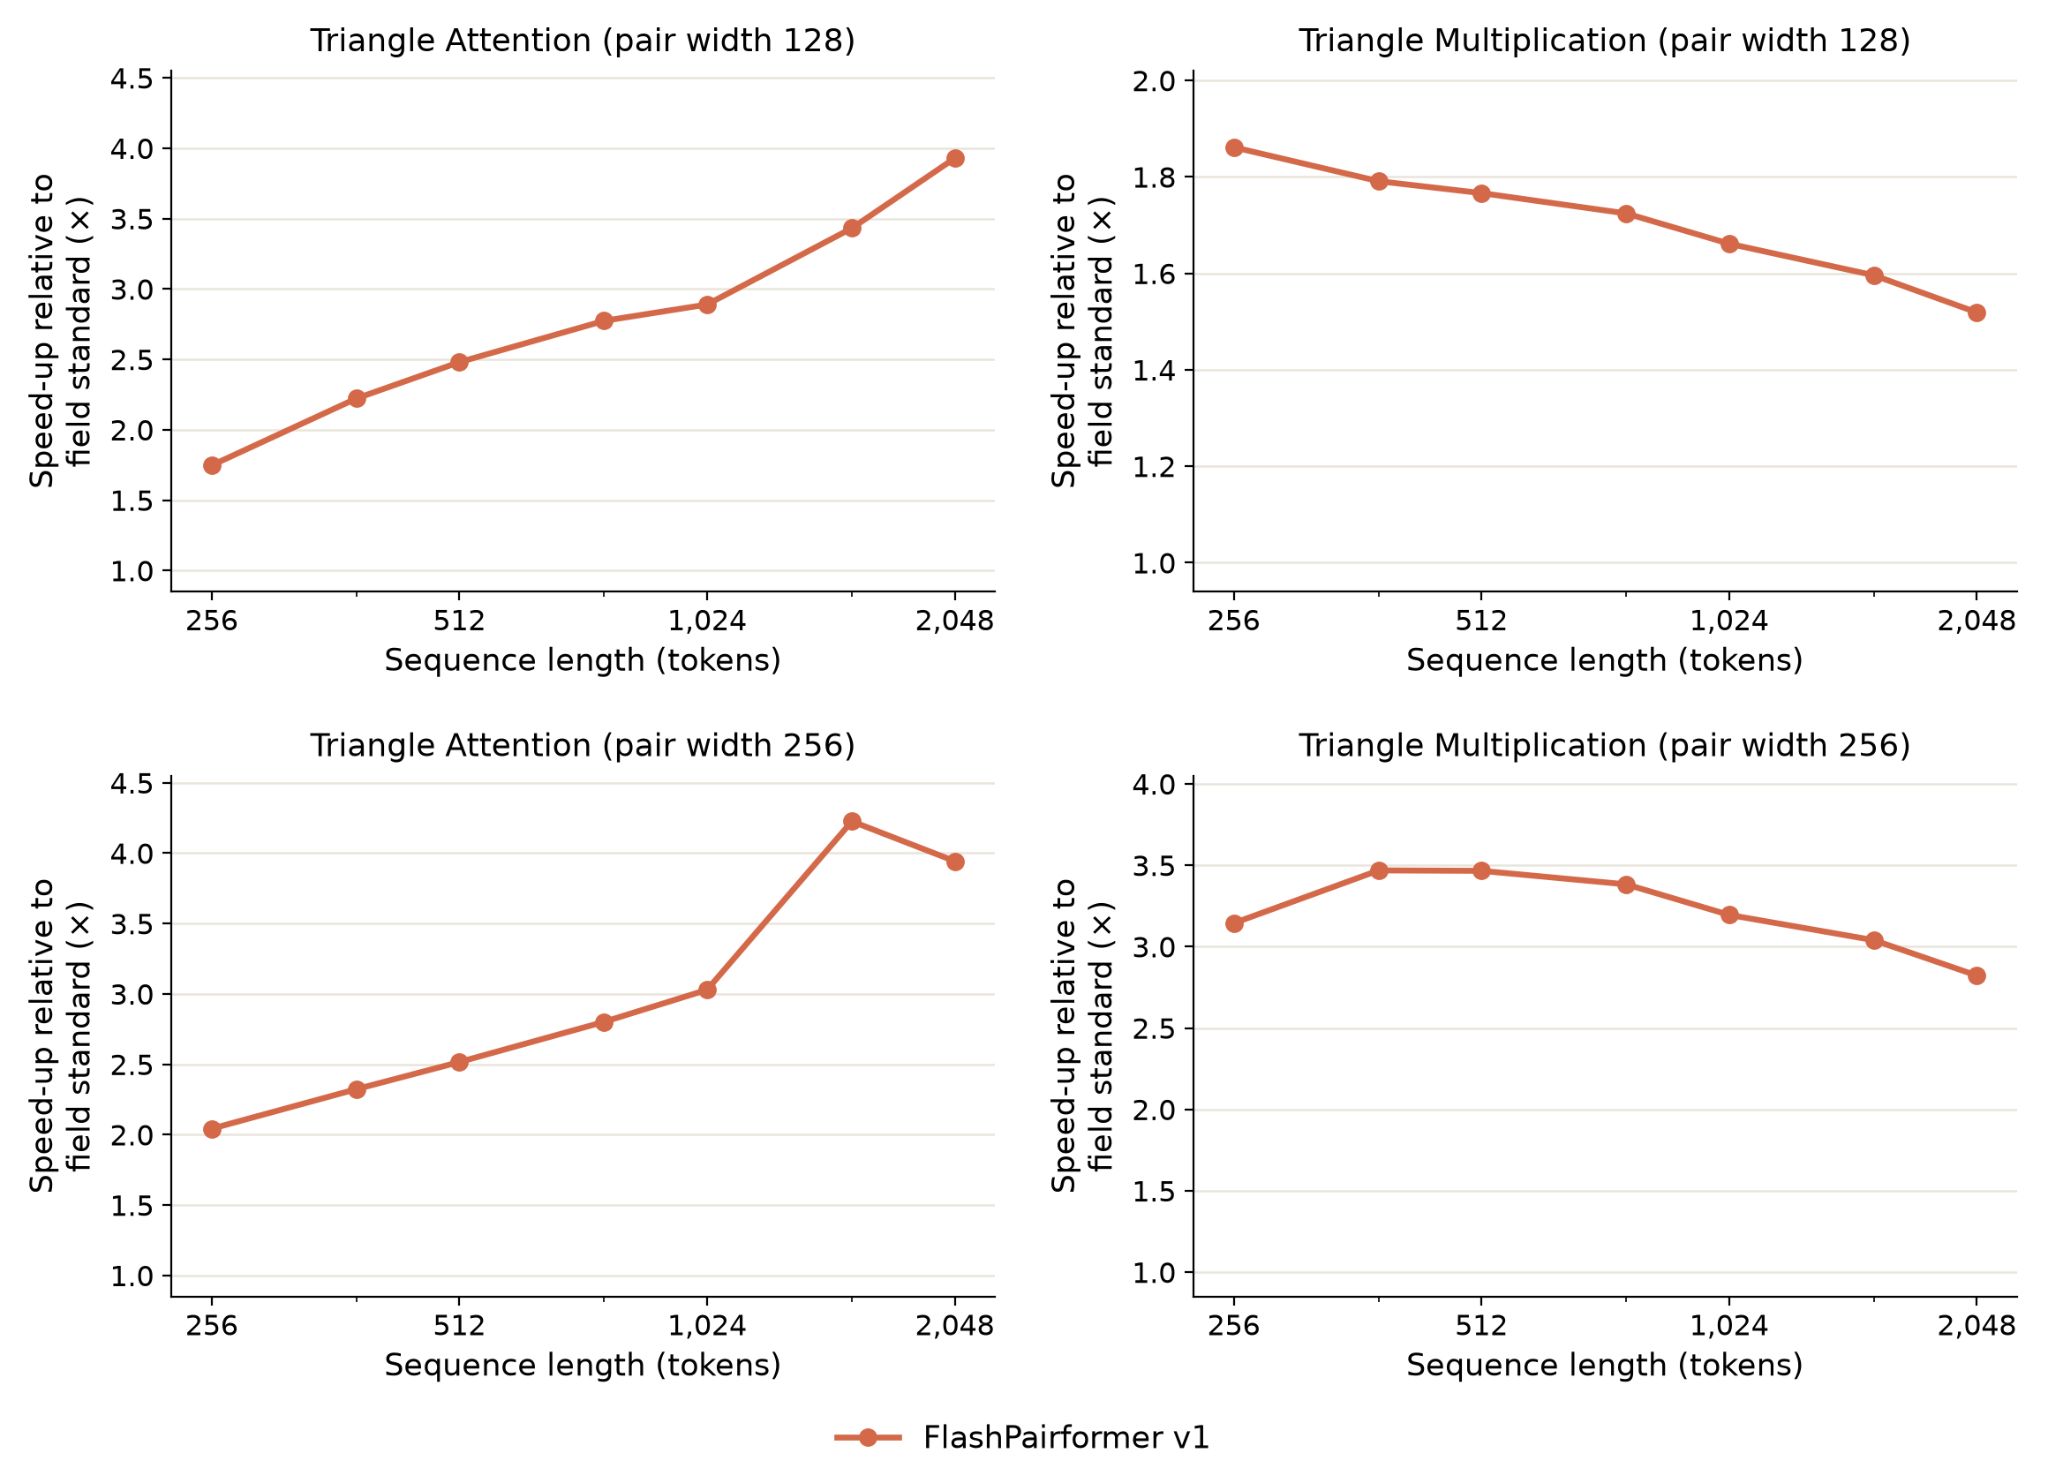
В рамках наших собственных усилий по оптимизации инференса для моделей предсказания структуры мы работали с Claude над разработкой FlashPairformer — набора пользовательских ядер, которые ускоряют треугольное внимание и умножение. Он устанавливает новый современный уровень, в среднем превосходя отраслевой стандарт в 2,7–2,9 раза для треугольного внимания и в 1,7–3,2 раза для треугольного умножения в зависимости от конфигурации модели.
Помимо разработки переносимых ядер, мы направили Claude на работу с каждой отдельной моделью с целью создания более специфичных оптимизаций. Они включали такие изменения, как кэширование избыточно повторно вычисляемой работы и упрощение неиспользуемых ветвей до их постоянных выходных значений. Сочетание этих улучшений ускорило модели предсказания структур в среднем в 4 раза, и для каждой модели мы подтвердили, что ускоренные Claude версии не повлияли на производительность в последующей задаче — такой как предсказание структуры.
Обычно опытной команде инженеров требуются недели, чтобы выполнить такие оптимизации для каждой модели, и эта работа часто не переносится между моделями. Claude под руководством двух сотрудников технического персонала Anthropic, имеющих опыт в биомолекулярном моделировании, но не имевших предыдущего опыта в оптимизации инференса или разработке ядер, выполнил ускорение более чем 30 моделей с открытым исходным кодом в областях предсказания биомолекулярных структур, дизайна белков, языкового моделирования белков и геномики менее чем за четыре недели. Наши результаты свидетельствуют о том, что передовые модели искусственного интеллекта помогут другим специалистам в этой области создавать научные инструменты быстрее и проще.
Обеспечение моделирования массивных биомолекулярных систем
Помимо ускорения этих моделей предсказания и проектирования структуры белков, мы также поручили Claude сократить использование памяти при моделировании крупных молекулярных машин. Значительная часть работы в клетке выполняется такими системами, включая рибосому, которая строит белки, дыхательные комплексы, обеспечивающие клетку энергией, и шапероны, помогающие другим белкам сворачиваться. Каждая из них состоит из десятков компонентов, и её функция зависит от того, как эти компоненты сочетаются и взаимодействуют. Предсказание структур столь крупных систем обычно требовало значительных вычислительных ресурсов, недоступных большинству молекулярных биологов, например инференса, распределённого между несколькими узлами графических процессоров.
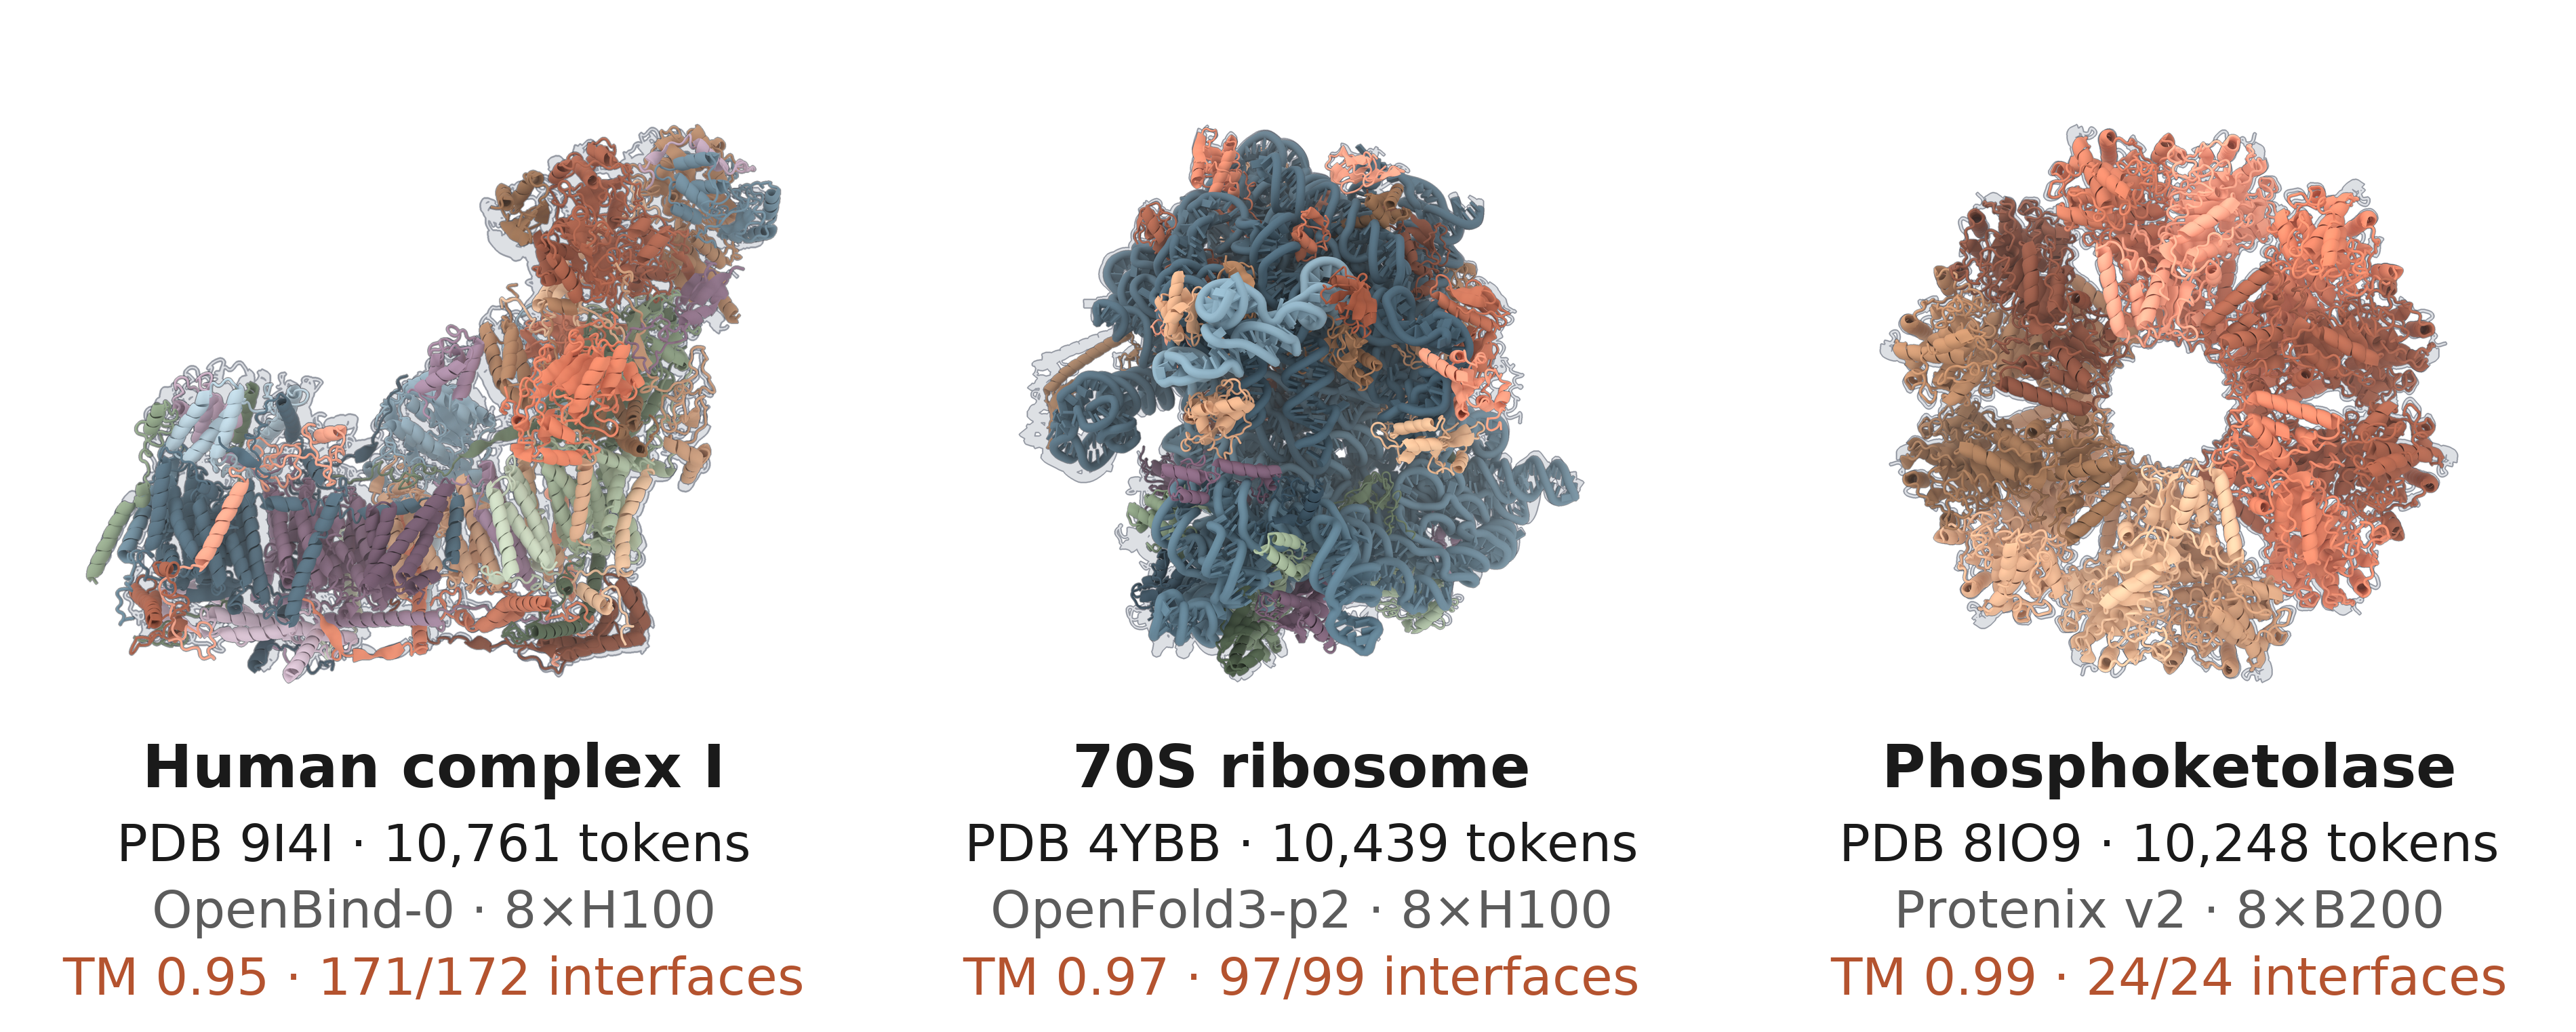
Claude создал режим «Big» с низким потреблением памяти, который позволяет точно моделировать системы размером более 10 0 токенов и успешно выполнять инференс на системах размером более 70 0 токенов, используя всего один узел графического процессора NVIDIA — задача, ранее недостижимая. Среди молекулярных машин, успешно свёрнутых с помощью режима Big, — митохондриальный комплекс I человека, комплекс шаперонина TRiC, протеасома и бактериальная рибосома; каждая из них близко соответствует своей экспериментально определённой структуре. Насколько нам известно, это одни из крупнейших структур, когда-либо точно свёрнутых с использованием моделей предсказания структуры; комплекс I и рибосома 70S состоят из более чем 10 0 токенов каждый, в сравнении с рибосомой 40S, точно предсказанной AlphaFold3, которая состояла из 7 063 токенов.
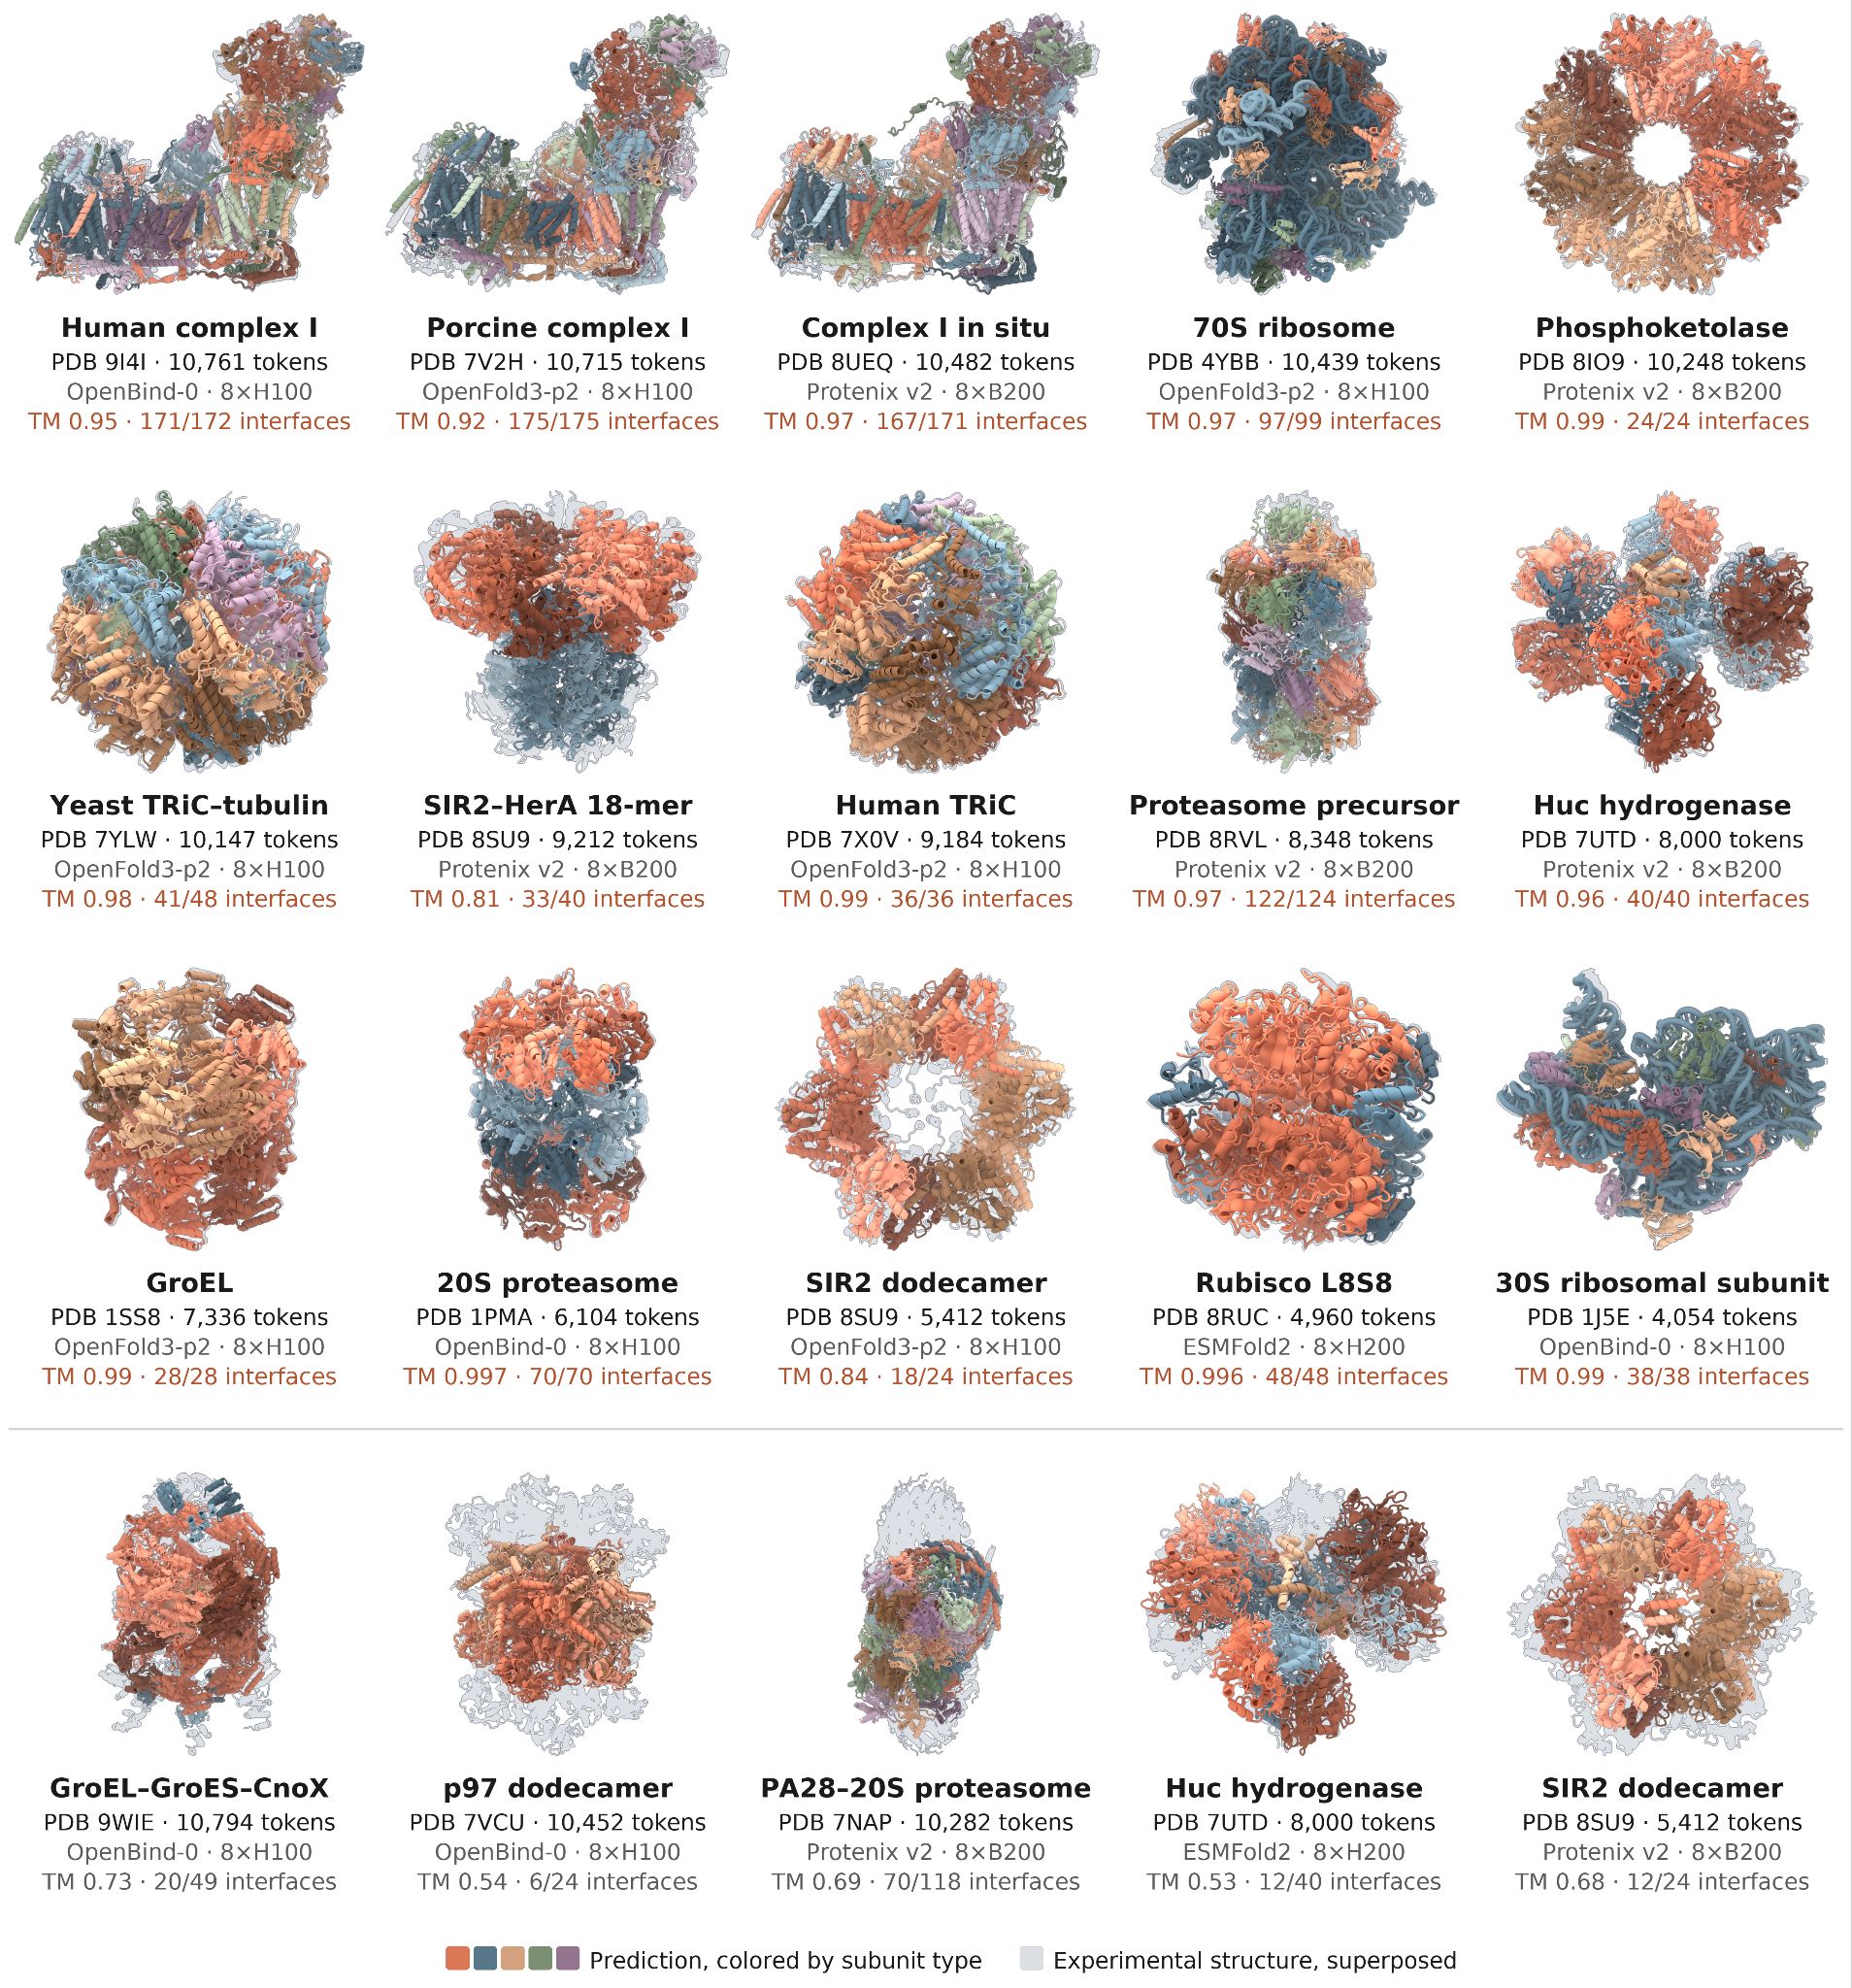
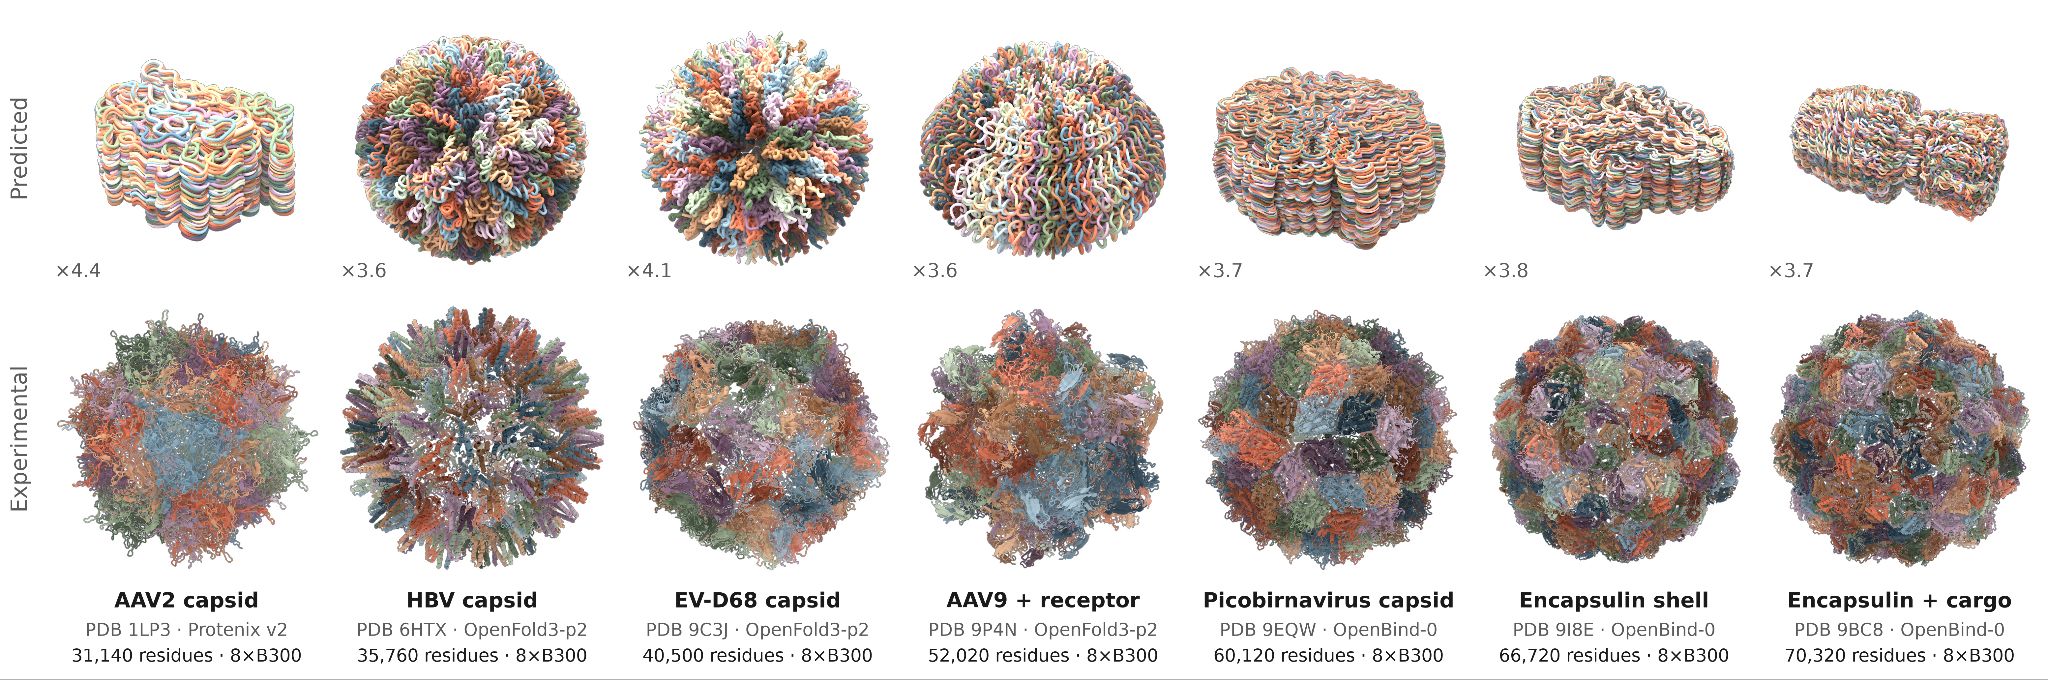
Чтобы проверить пределы оптимизаций Claude, мы попросили Claude предсказать структуры большего размера, чем всё, что когда-либо удавалось достичь ранее. Используя один узел B300 с 8 графическими процессорами, Claude сгенерировал предсказания целых вирусных капсидов и белковых компартментов размером от более чем 31 000 до более чем 70 000 токенов. Эти системы почти на два порядка больше, чем обучающий контекст этих моделей предсказания структур, и, возможно, неудивительно, предсказываются неверно. Однако барьер для инференса в таком масштабе был значительно снижен: теперь требуется всего один узел NVIDIA B300, что позволяет предположить, что с улучшением инструментов исследователи вскоре смогут вычислительно моделировать всё более сложный набор биологических систем.
Claude эффективно разрабатывает белковые связывающие молекулы de novo
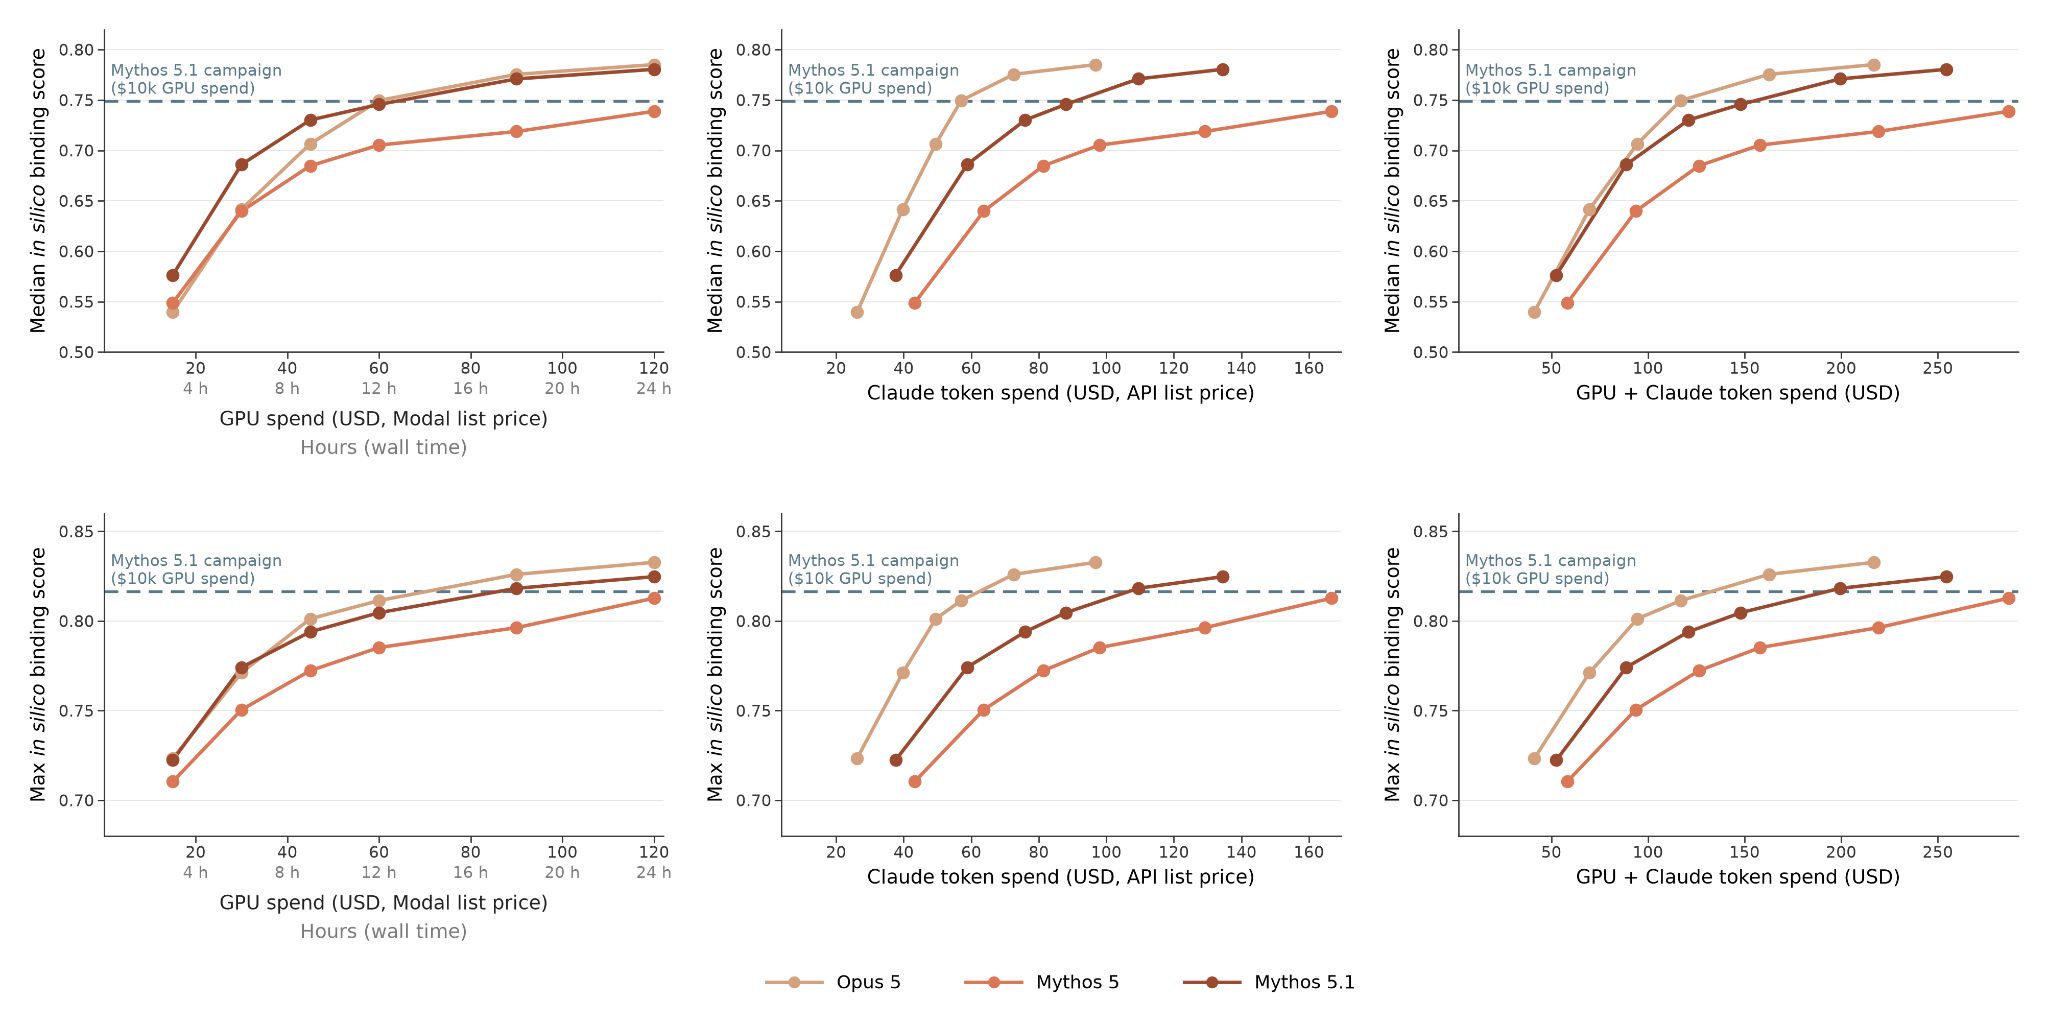
В нашей более ранней работе по дизайну белков мы предоставили Claude промпт объёмом примерно 16 000 слов, который побуждал его использовать субагентов и тратить до 10 000 долларов США на каждую мишень в Modal — примерно 2 500 часов работы графических процессоров NVIDIA H100 — в течение 24 часов. Здесь мы предоставили одной модели Claude доступ к одному NVIDIA H200 и 24 часам фактического времени, промпт объёмом около 1 100 слов и справочный лист для предустановленных инструментов — без субагентов и без участия человека в управлении процессом разработки.
Мы запустили три модели Claude (Mythos 5.1, Mythos 5 и Opus 5) на 16 целях с использованием ускоренных биомолекулярных моделей, описанных в этой публикации. Мы оценивали дизайны по показателю ipSAE, оценке in silico, которая, как было показано, предсказывает связывание в лабораторных условиях. В среднем по 16 целям дизайны со средним и наивысшим баллами от всех трёх оценённых моделей Claude достигают примерно тех же значений ipSAE, что и наши более ранние кампании Mythos 5.1, несмотря на использование примерно на два порядка меньшего количества часов работы графических процессоров. Мы также учли затраты на токены Claude и обнаружили, что при совокупных расходах примерно в 150 долларов США на графические процессоры и токены мы можем достичь производительности in silico, соответствующей уровням наших предыдущих кампаний.
Совместное спонсирование соревнования по дизайну белков с Adaptyv Bio
Описанные выше оптимизации помогают нам более эффективно прогнозировать и проектировать молекулы, одновременно открывая возможности, которые в противном случае потребовали бы чрезмерных ресурсов. Чтобы продемонстрировать обеспечиваемое ими улучшение и влияние Claude на разработку молекул в более широком смысле, мы сотрудничаем с Adaptyv Bio, чтобы запустить конкурс по проектированию белков. Мы выбрали пять задач на переднем крае современных возможностей проектирования белков, включая такие вызовы, как межвидовая перекрёстная реактивность, чувствительность к pH и специфичность пептид-MHC, а также сложные мишени, такие как GPCR.
Совместно с командой Adaptyv мы будем экспериментально проверять более 5 00 разработок, представленных сообществом, на соответствие этим задачам. Мы предоставим участвующим исследователям до 1 миллиона долларов США в виде кредитов Claude и дополнительные средства для экспериментальной проверки в Adaptyv, Modal предоставит до 250 00 долларов США в виде вычислительных кредитов, а Twist Bioscience предоставит ДНК для конкурса. Вы можете найти дополнительную информацию, включая критерии соответствия требованиям (здесь) и (подать заявку здесь).
Мы также начали предоставлять передовые возможности искусственного интеллекта специалистам по наукам о жизни для работы, связанной с биологией, в рамках нашей Программы верификации в области наук о жизни. Недавно мы приняли первую группу организаций и сегодня открыли программу в рамках публичной бета-версии. Вы можете найти дополнительную информацию (здесь).
Дополнительное чтение
Следующие ресурсы содержат дополнительные технические подробности и более детальную информацию о результатах, описанных выше:
- Страница конкурса по дизайну белков и форма заявки;
- Код для специализированных молекулярных моделей;
- Технический отчёт.
Источник
How Claude is uplifting biomolecular modeling
https://www.anthropic.com/research/claude-uplifts-biomolecular-modelingРедактор русской версии: Пётр Смывин.
Разбор подготовлен 18 сентября 2026.